亚马逊加入了销毁善本书籍以供人工智能机器使用的公司名单
编辑部 · 发布 2026/08/18 · 更新 2026/08/18
隐藏在一本稀有书籍中的 AirTag 一路被运往拉斯维加斯仓库,在那里它很可能被销毁,以向饥饿的法学硕士提供新鲜数据。 我不知道你是否注意到,一切都变得越来越由人工智能生成。无论是新闻、音乐还是社交媒体,人工智能似乎都把所有肮脏的小手指伸进了它能找到的任何馅饼中。
隐藏在一本稀有书籍中的 AirTag 一路被运往拉斯维加斯仓库,在那里它很可能被销毁,以向饥饿的法学硕士提供新鲜数据。
我不知道你是否注意到,一切都变得越来越由人工智能生成。无论是新闻、音乐还是社交媒体,人工智能似乎都把所有肮脏的小手指伸进了它能找到的任何馅饼中。
专家们早就警告说,最终我们将达到人工智能利用人工智能创建的数据进行自我训练的阶段,而且我们非常确定这一点已经过去了。事实证明,这实际上并不是特别有用。
当一切听起来都像从 ChatGPT 提示后面掉出来一样时,通过图灵测试就更难了。这就是为什么人工智能公司并不真正想要人工智能版本的人体蜈蚣。
他们希望利用人类制作的内容来训练人工智能。作为一个制作人工内容的人,你会认为当我听到我至少在管道中占有一席之地时我会感到欣慰。
不幸的是,这些公司告诉其他公司,他们可以摆脱人类,转而使用超高效的类人产品。
那么,在人类蜈蚣的类比中,这对我来说具体意味着什么呢?我是在前面,还是他们试图在中间的某个地方为我找到一个空间?
开玩笑,他们真的根本不希望人类参与这个过程。
这就是为什么他们直接销毁书籍。
拉斯维加斯东北部的一个仓库里……
去年,稀有书商的销售额出现了历史性的飙升。因此 404 Media 联系了一位人士,看看他们是否可以追踪谁在购买这些书。
卖家同意将 AirTag 隐藏在一本珍本书中,该书是 1,000 本书的较大订单的一部分。这本书从加利福尼亚州传到密尔沃基,然后从密尔沃基传到科罗拉多州大章克申。
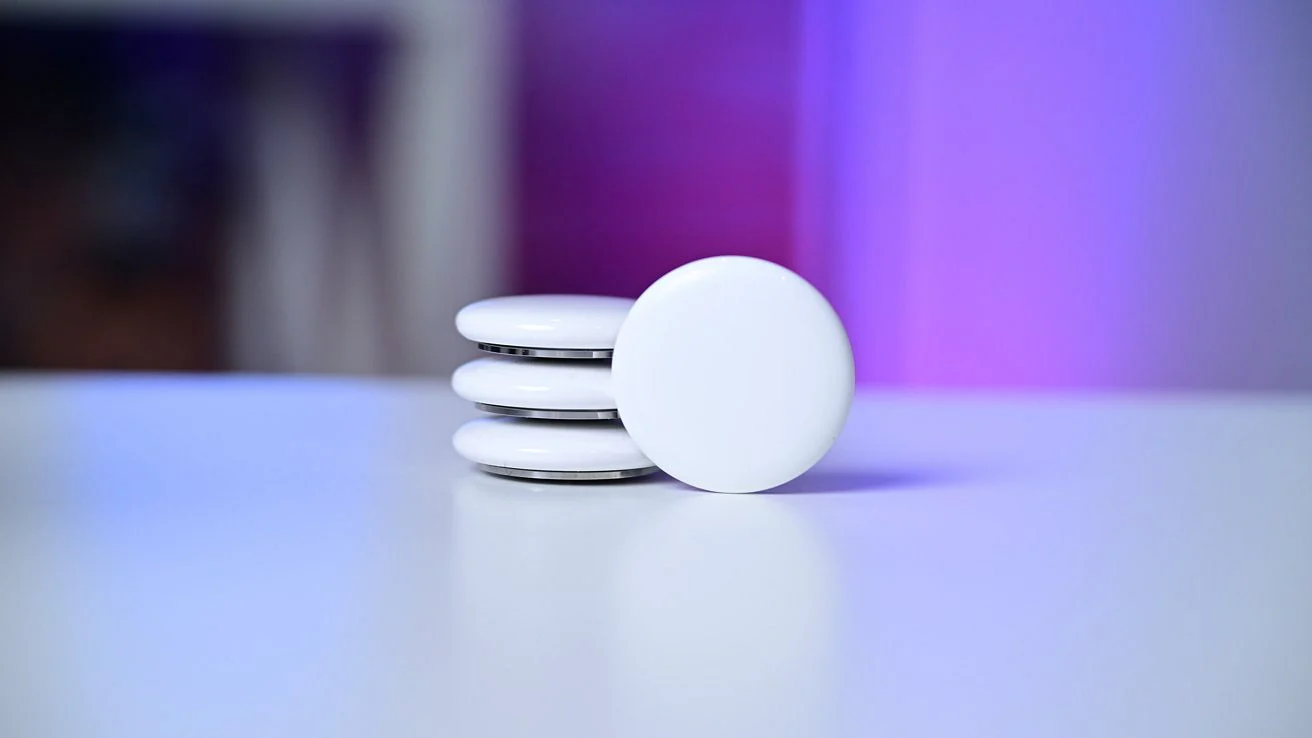
AirTag 用于追踪书籍到达最终目的地
几周后,它到达了最终目的地:内华达州拉斯维加斯。
具体来说,它最终停在了一个名为“LAS8”的亚马逊仓库。通常,LAS8 是一家按需印刷的图书销售公司。
但404得知仓库北端不生产书籍。相反,它会摧毁它们。
该位置被称为 VGT3。书籍在这里被接收、分类和处理。处理过程需要切断书脊,并将页面送入扫描仪,将扫描结果转换为数据。
这些数据无法在任何地方获得,它们不会被扫描成 PDF 来阅读。它专门用于训练人工智能。
剩余的书籍被丢弃。这些内容绝不适合人类查看,只能由人工智能查看。
如果这是一部电影,我会斥责编剧是个黑客。但不幸的是,这正是我们现在生活的现实。
欢迎来到未来,亲爱的读者。是否如您希望的那样令人兴奋?
21世纪焚书
不幸的是,数据是有限的。尤其是对于大语言模型而言。
造成这种情况的原因有很多,但有两个主要原因似乎让人工智能公司和研究人员感到紧张。
首先是模型崩溃。当人工智能反复训练自己的数据时,最终数据会变得越来越无用。
当这种情况发生时,人工智能将产生通用的、无用的信息。实际上,这与复印复印件的复印件时发生的情况相同。
第二是AI会产生幻觉。事实上,它产生了很多幻觉。因此,如果一个模型根据另一个模型的幻觉进行训练,则幻觉将被视为基线。
现在想象一下这种情况一遍又一遍地发生。最终你会到达模型崩溃的同一点,但这一次,人工智能会在幻觉最终变得无法使用之前将其引用为事实,从而带来额外的危险。
所有道路都通向同一地点。这不是一个任何人都真正有兴趣去的地方,或者留在那里,就像我的编辑认为的那样。
互联网上几乎所有可用的人工训练数据都已经被法学硕士吞噬了。而且,如前所述,新数据绝大多数是由人工智能产生的。
因此,人工智能公司需要弄清楚如何规避数字衔尾蛇效应。但是,如果人类无法足够快地创建新数据,那么您在哪里可以找到新信息来输入机器呢?
嗯,正如我们上面了解到的,这显然是通过销毁书籍来实现的。对于人工智能训练数据而言,书籍是一座金矿。
实体书就更好了。其中包含的大部分信息尚未数字化,这意味着它是原始的原始数据。
而且数据并不需要是“真实的”;它只需要独一无二,不受人工智能的污染。它只需要训练算法背后的数学。
这就是稀有书商销量增长的原因。法官裁定,公司这样做是可以的,只要他们之后不出售数字化版本。
亚马逊并不是第一家这样做的公司。 Anthropic也做到了这一点。事实上,我敢打赌大多数大型商业人工智能公司已经这样做了一段时间了。
最终,这些公司将耗尽书籍。一些极其稀有的书籍很可能会在这个过程中完全丢失。
在某个时刻,石头会停止流血,但我严重怀疑人工智能的力量是否会停止挤压。
来源:Appleinsider