编程能力提高50%!GLM-5.3 满分通过了GPT-5.6给的Coding 测试
编辑部 · 发布 2026/08/17
北京时间 8 月 14 日,GLM 5.3 正式发布。GLM 5.3 围绕 GLM 5.2 已经搭建完成的长程强化学习技术栈持续扩大训练规模,包括增加更多任务环境、提高任务多样性,并投入更多计算资源进行强化学习训练。
北京时间 8 月 14 日,GLM-5.3 正式发布。GLM-5.3 围绕 GLM-5.2 已经搭建完成的长程强化学习技术栈持续扩大训练规模,包括增加更多任务环境、提高任务多样性,并投入更多计算资源进行强化学习训练。
当前,GLM-5.3 已经向全部 GLM Coding Plan 用户开放,并可用于 ZCode、Claude Code、OpenCode 等 Coding Agent。新的 Coding Plan 同时改为积分制额度体系,输入 Token、缓存输入 Token 和输出 Token 分别计算积分。工作日北京时间 14:00 至 18:00 为高峰时段,其余时间包括周末均按照标准积分消耗的 50%计算。
智谱还在自家 Coding Agent ZCode 中进一步强化了缓存和长程任务能力。官方称其缓存命中率可以达到 98%以上,重复上下文按照更低的 Cached Token 费率计算,相当于可以增加约 30%的有效 Token 使用量,同时截至 8 月 31 日还提供 1.5 倍限时额度加成。此外,ZCode 还提供 Goal Mode,可以围绕一个目标持续完成规划、编码、测试和验证,并支持通过微信或飞书远程查看和控制长时间运行的任务。
官方将在大约两周完成安全评估和加固工作,随后正式公开 GLM-5.3 模型权重。
AI 测 AI:GPT-5.6 肯定 GLM-5.3
我们让 GPT-5.6 sol(最高)设计了可直接交给 ZCode 的测试压缩包,评分器会生成 zcode-test-results.json,总分 100 分,每项 20 分,五个小测试包括:
- low/high/max 推理强度、JSON 遵循、延迟和令牌消耗
- 算法代码生成,运行 510 项固定、随机和性能测试
- 小型仓库缺陷修复,包括拓扑排序、异常处理和循环检测
- 多轮工具调用,检查库存预留、超卖和任务完成情况
- 受控安全审计,验证路径穿越、符号链接逃逸等补丁 提示词如下:
请先完整阅读当前项目根目录的 TASK.md,然后连续完成其中五项测试。
执行要求:
-
先检查 workspace/ 中现有文件,再制定简短计划;
-
只修改 workspace/,不要修改 grader.py、TASK.md、START_PROMPT.txt;
-
不访问网络、不安装依赖、不调用其他模型或外部服务;
-
每完成一项就运行 python3 grader.py,依据真实错误继续修复;
-
不得删除测试、绕过评分器、硬编码 grader.py 中的随机样例或伪造运行结果;
-
全部完成后再次运行 python3 grader.py,并在根目录创建 TEST_REPORT.md,写明五项结果、总分、耗时、关键实现和仍存风险。
请现在开始执行,不需要向我确认中间步骤;除非遇到需要扩大权限或无法从本地材料判断的阻塞。
整个期间,除了权限确认外,没有其他额外操作。大约 13 分钟后,五项测试全部完成,并且满分通过。最后,GLM-5.3 还给出了一份任务报告。
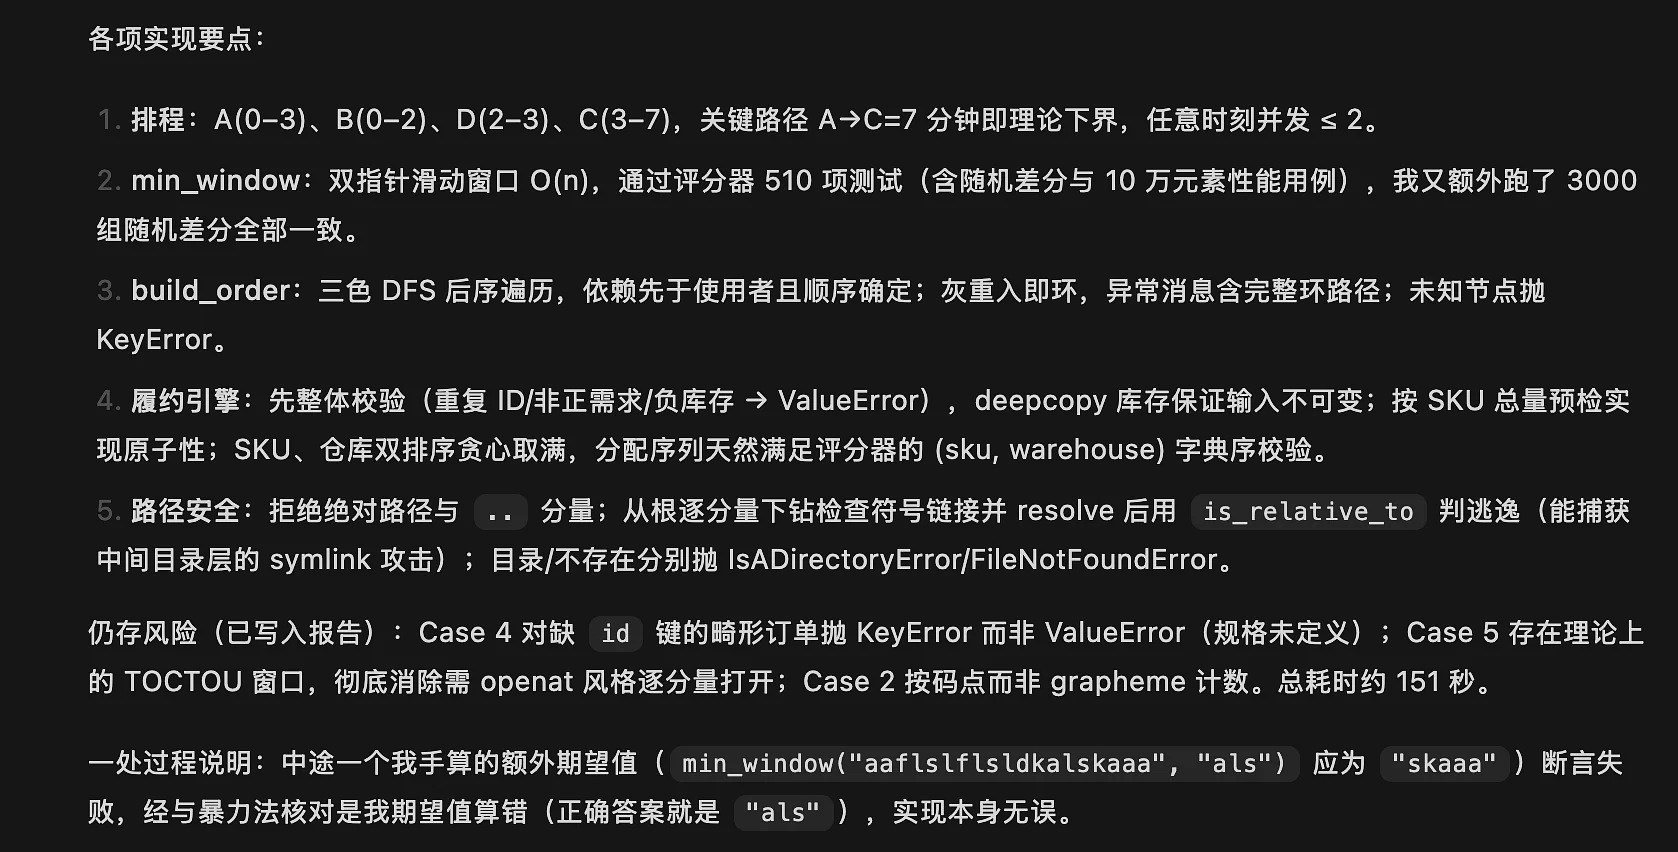
对于这次测试,GPT-5.6 sol 的结论是:这次测试说明 GLM‑5.3 在 ZCode 中的“受约束工程执行能力”很强,可评为 A−。
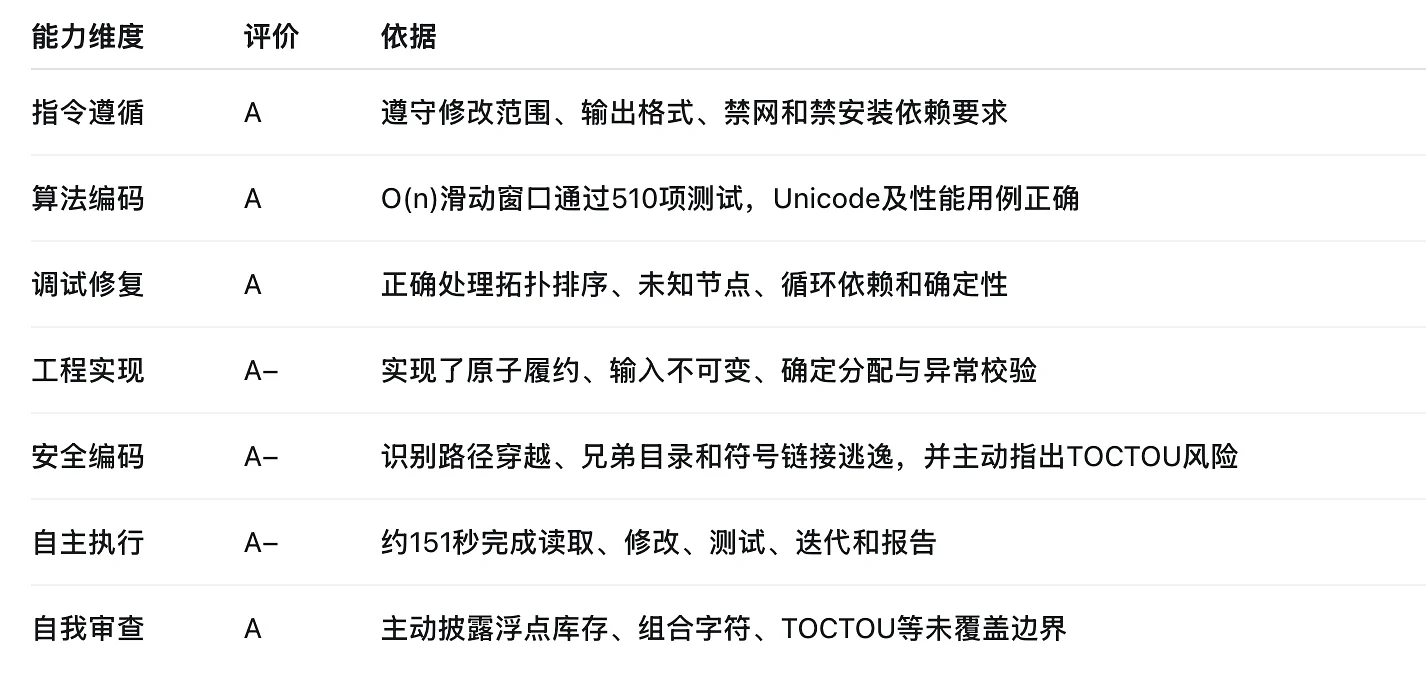
具体来看,GLM‑5.3 首先不只是“写出能运行的代码”,而是理解了任务中的原子性、确定性、异常语义和安全边界;其次,实现方式基本符合常规工程写法,没有明显为了测试而硬编码答案;再者,自我审查质量较高,报告指出的风险与实际代码基本一致;最后,151 秒完成 5 项任务,作为小型离线工程测试,效率不错。不过这不是纯模型推理延迟,还包含文件操作和测试执行时间。
但不能仅凭这次 100 分就认定它在大型系统工程或真实安全任务中达到前沿闭源模型水平。任务主要是小型、单文件、规格清晰的 Python 问题,远低于真实大型仓库的复杂度,也没有测试跨语言项目、并发、数据库、前端、编译系统、模糊需求或长上下文等能力。
编程能力提高 50%,来自后训练
本次所有性能提升均来自后训练。
GLM-5.3 后训练基础设施主要由三部分组成:用于高效长上下文处理的 IndexShare、面向长程任务强化学习的 SAO,以及大规模异步训练框架 slime。
智谱表示,GLM-5.2 阶段已经基本完成相关技术栈建设,因此 GLM-5.3 的核心工作可以概括为一件事,即继续 Scaling post-training。结果显示,即使基础模型保持不变,模型在复杂代码、长程 Agent 任务以及网络安全等方向仍然出现了明显提升。
在代码能力上,智谱称 GLM-5.3 在内部智谱 Code Bench 上的成绩相比 GLM-5.2 提高约 50%。
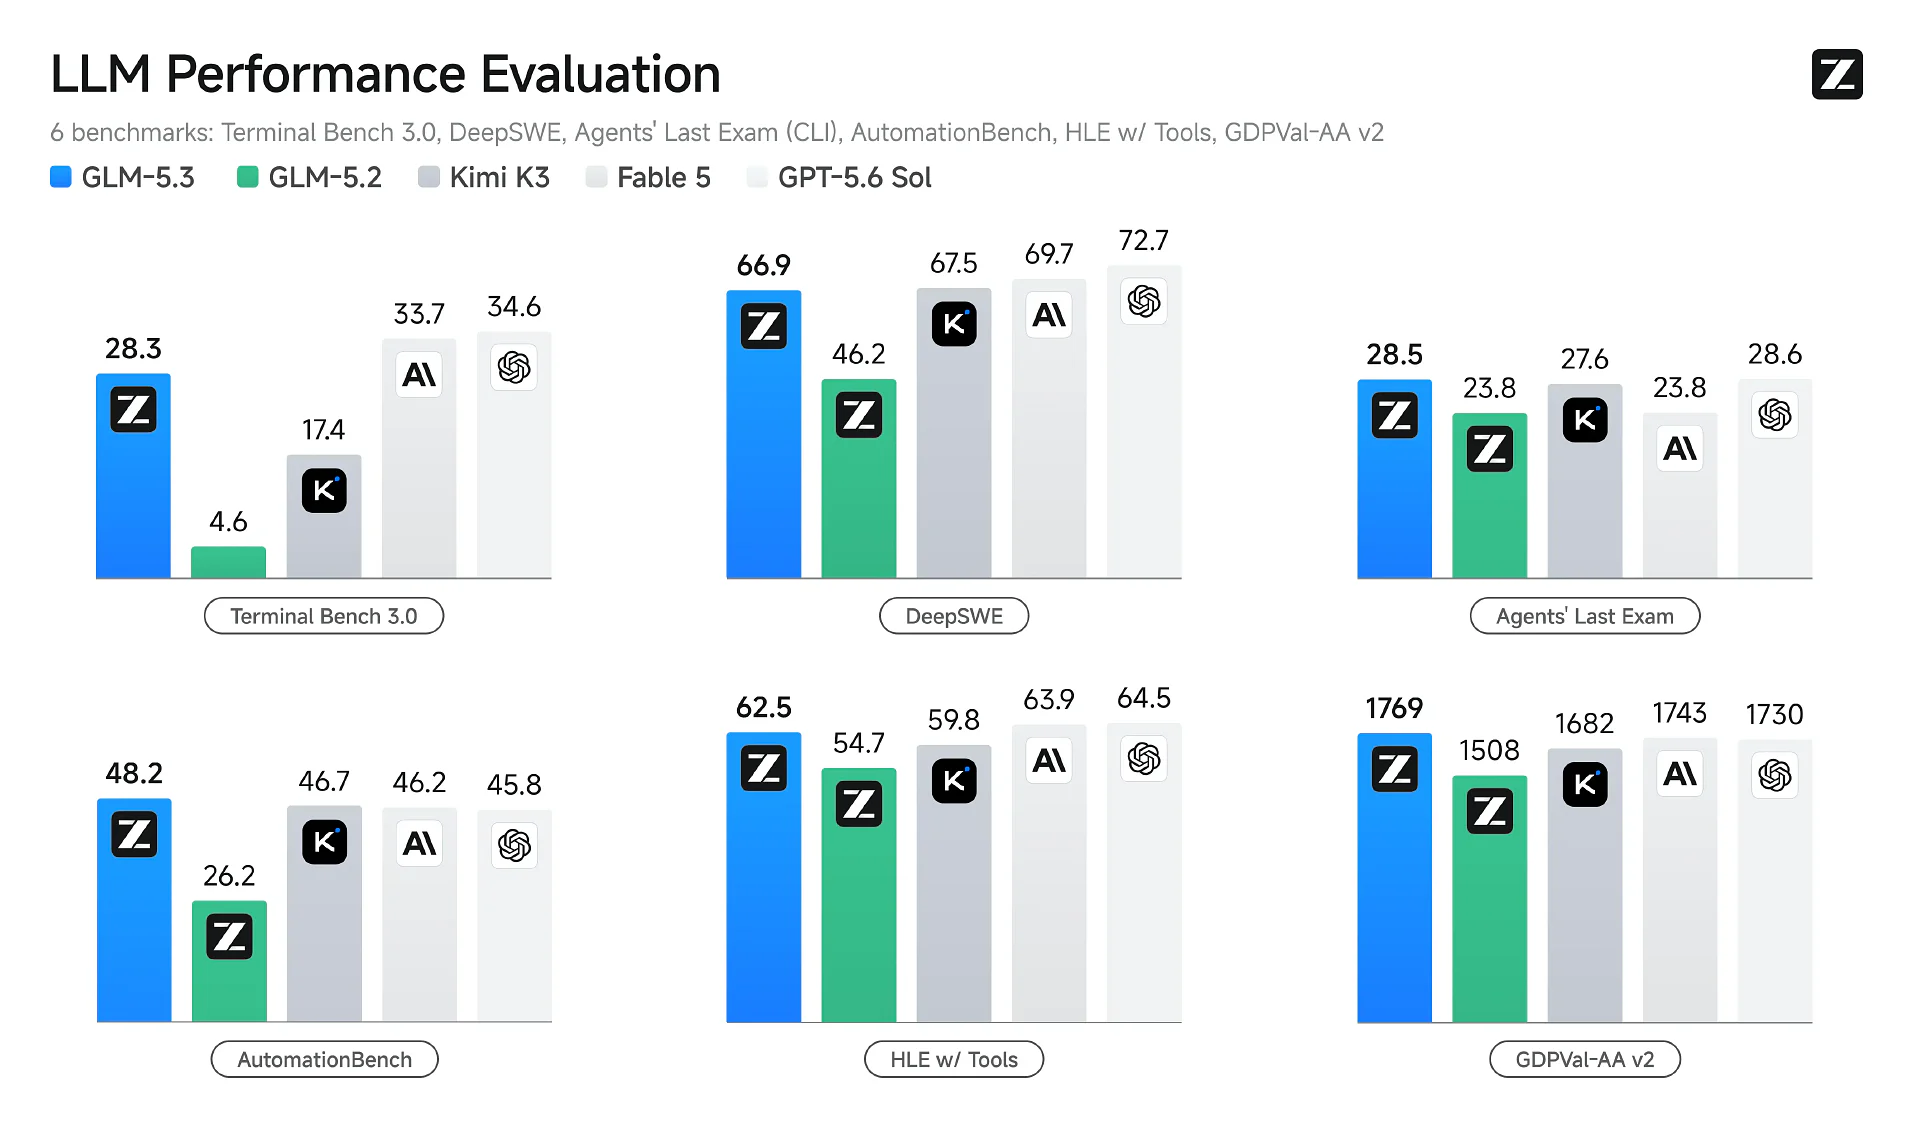
值得注意的是,智谱此次重点扩大了一类更接近真实工程工作的训练环境,让任务从“写一段代码”逐步变成“独立承担一项工程工作”。部分训练任务甚至对应一名有经验工程师数天才能完成的工作量。
以机器学习基础设施任务为例,模型可能获得与真实工程师类似的工作环境,包括计算集群、存储系统、内部文档、代码仓库以及实验结果,需要自行诊断整个训练栈中的性能瓶颈、实现优化方案、运行实验,并最终在保证正确性的前提下实现可以量化的端到端性能提升。
这意味着,智谱团队的训练目标已经转向了让“Agent 能否从头到尾接管一项复杂任务”。在这种训练方式下,用户不再需要事先把复杂问题拆成大量小步骤,再逐步监督模型执行。
只依靠人工制作少量任务已经难以支撑强化学习继续扩展。为此,智谱建立了一套自动化环境生成流水线:Research Agent 从真实工作中收集任务模式,并将其转化为包含多步骤依赖关系和隐藏状态的可执行长程环境;随后由 Judge Agent 实际尝试任务,判断任务是否真正可解。
与此同时,系统还会在不知道标准答案的情况下自动生成 Verifier,用于判断 Agent 最终是否完成任务。为了降低模型通过奖励漏洞“投机取巧”的风险,训练过程中还会分析 Solver 轨迹寻找 reward shortcut,并持续修补验证规则。智谱表示,这套流程目前仍然需要相当程度的人工参与,进一步提高环境生成和验证环节的自动化程度将是后续重点之一。
关注长程能力,同时减少 token 消耗
GLM-5.3 同时继承了 GLM-5.2 阶段引入的长程强化学习策略,包括支持上下文压缩的 SAO。其目的并不是只让模型在短任务上取得更高分,而是让强化学习带来的能力提升能够保持到更长的 Agent 执行轨迹中。从公开 Benchmark 结果来看,这一变化已经同时体现在代码任务和通用 Agent 任务上。
为了减少公开测试集污染带来的影响,智谱此次还公布了内部测试集智谱 Code Bench。该测试主要模拟真实用户使用 Coding Agent 时面对的复杂本地开发环境,覆盖多个任务类别,并按照不同推理强度,从端到端任务完成率和细粒度 Checklist 准确率两个维度进行评价。
支撑长程强化学习训练的核心基础设施之一,是智谱开源的后训练框架 slime。该系统训练侧采用 Megatron、Rollout 侧采用 SGLang,并将训练、Rollout 和数据 Buffer 组织在同一数据流中。数学、代码、Sandbox、Verifier 及长程 Agent 环境均可作为数据生成环节接入,无需为新增任务重建训练循环。这为 GLM-5.2 到 GLM-5.3 持续扩展训练环境提供了基础。
GLM-5.3 期间,slime 主要从算法和系统效率两方面升级。算法侧新增 top-p mask、top-k 及全词表 OPD,并通过 R3 类配置和训练、Rollout 路径的数值对齐提升一致性。智谱称,两条路径输出 log probability 的平均差异已控制在 10^-7 量级,较此前降低超过 99.99%。
系统侧,slime 引入本地存储缓存,对模型状态和数据进行分层管理,减少 Host Memory 占用。在多 Teacher OPD 训练中,动态 Teacher 切换和训练侧预取机制可避免为每个 Teacher 长期部署独立推理服务,从而降低资源成本。
针对 Agent 及异步强化学习任务,slime 还优化了 Router 与训练系统之间的联合调度和负载均衡。新的 workload-aware 策略可根据任务特征自动调整 Prefill 与 Decode 资源比例、并发配置等关键参数。智谱表示,这些优化使长程 Coding RL 的端到端训练吞吐提升超过 2.3 倍,能够以更低成本训练更长轨迹和更复杂环境。
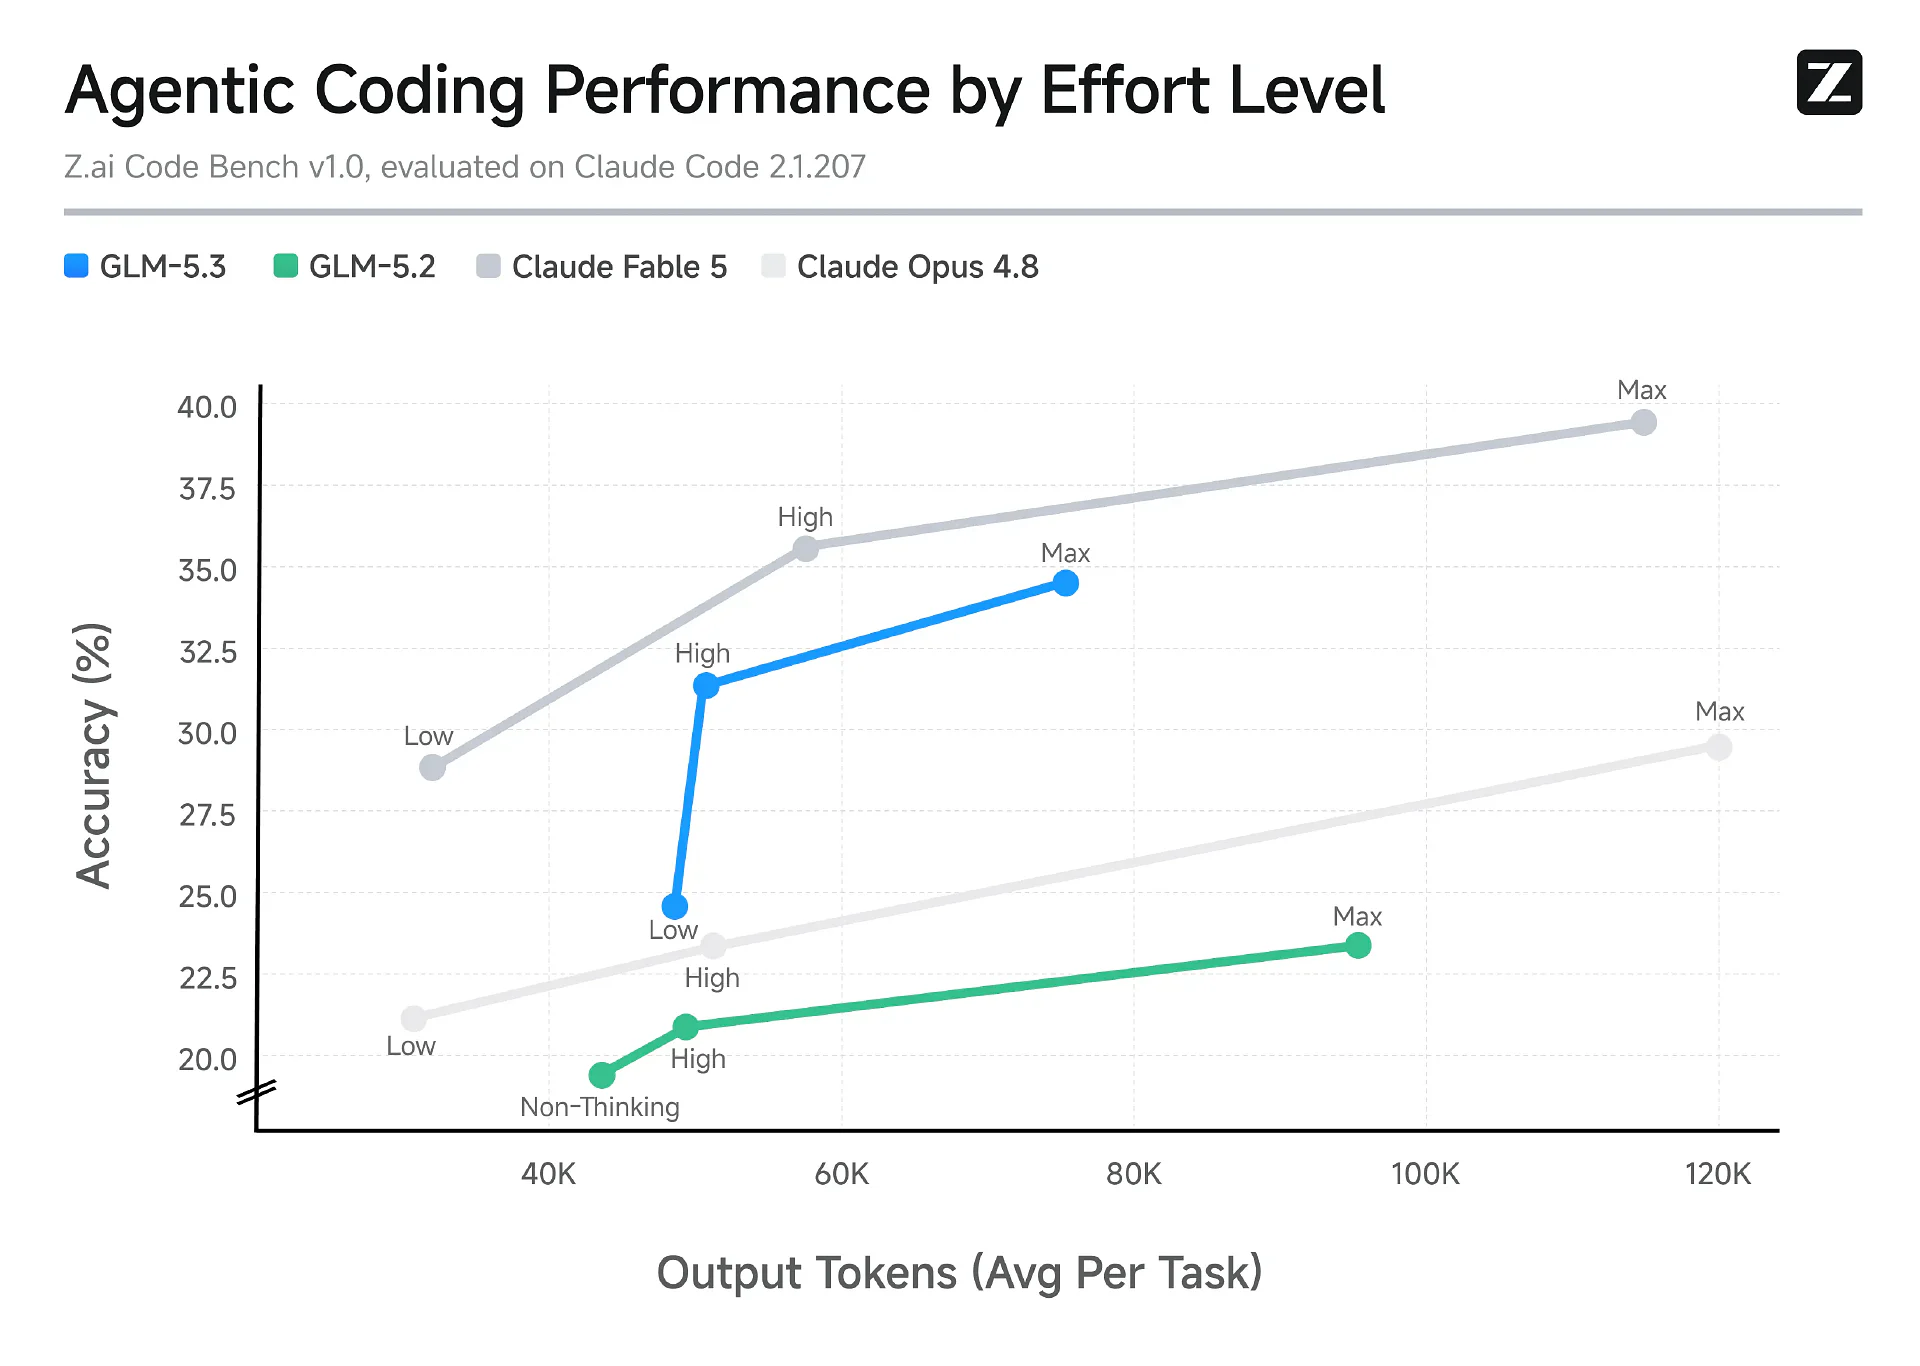
当前模型不仅要看“最终能不能完成任务”,还需要看为了完成任务需要进行多少轮推理、输出多少 Token 以及消耗多少计算资源。测试结果显示,GLM-5.3 不仅性能提高,完成任务所需的输出 Token 也明显下降。
在 Max effort 下,GLM-5.3 使用每项任务约 7.5 万输出 Token 取得 34.5%的成绩,而 GLM-5.2 需要约 9.6 万 Token,成绩为 23.4%。在 High effort 下,GLM-5.3 使用约 5 万输出 Token 取得 31.4%,高于 Claude Opus 4.8 约 12 万输出 Token 下的 29.5%。不过 GLM-5.3 距离 Claude Fable 5 仍然存在差距,后者在 Max effort 下取得 39.5%。
发力安全能力
除了 Coding,GLM-5.3 此次一个较为意外的变化来自网络安全能力。
智谱表示,团队在后训练数据和环境中加入了漏洞发现相关任务,最初目标只是提高模型寻找和分析漏洞的能力,但随着强化学习训练规模扩大,相关能力增长速度超过预期。模型不仅更擅长定位单个漏洞,也开始能够跨越漏洞利用的多个阶段进行推理,并形成相对完整的攻击利用链。
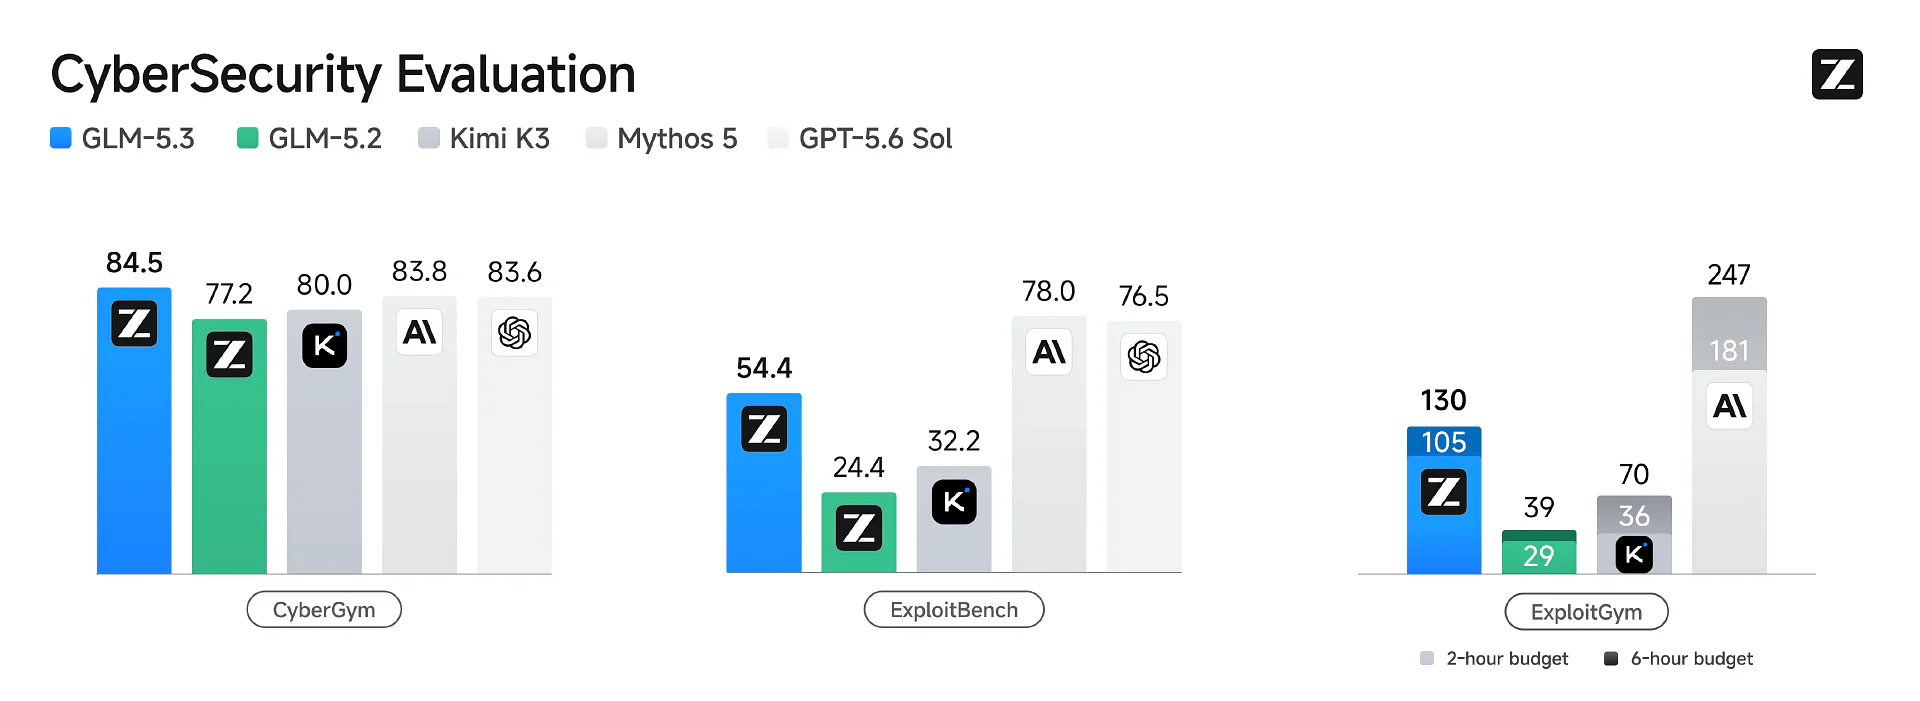
在 CyberGym 测试中,GLM-5.3 取得 84.5%的成绩,高于 GLM-5.2 的 77.2%,同时超过 GPT-5.6 Sol 的 83.6%。这一测试从白盒源代码出发,要求模型发现漏洞并通过触发故障验证漏洞。在更加考验真实漏洞利用推理能力的 ExploitBench 上,GLM-5.3 由 GLM-5.2 的 24.4%提升至 54.4%,提升超过一倍,不过仍低于 Claude Opus 4.8 的 78.0%和 GPT-5.6 Sol 的 76.5%。
智谱还将相关能力用于真实开源项目测试。自 GLM-5.2 以来,团队与中国多家安全团队合作,在真实代码库中运行模型。经过专家复核、筛选和去重后,模型共发现 2436 个漏洞,覆盖 269 个开源项目,其中包括 1097 个高危及严重漏洞。涉及范围包括系统内核、操作系统、浏览器引擎、开源基础设施、Web 应用以及网络协议。
按照智谱公布的数据,这 2436 项发现中目前已有 53 项公开披露,2383 项仍处于漏洞披露保护期。按严重程度划分,包括 107 项 Critical、990 项 High、1286 项 Medium 以及 53 项 Low。部分漏洞已经在代码中存在数十年,最早可以追溯至 1981 年,平均每个漏洞在被发现前已经存在 26.6 年。
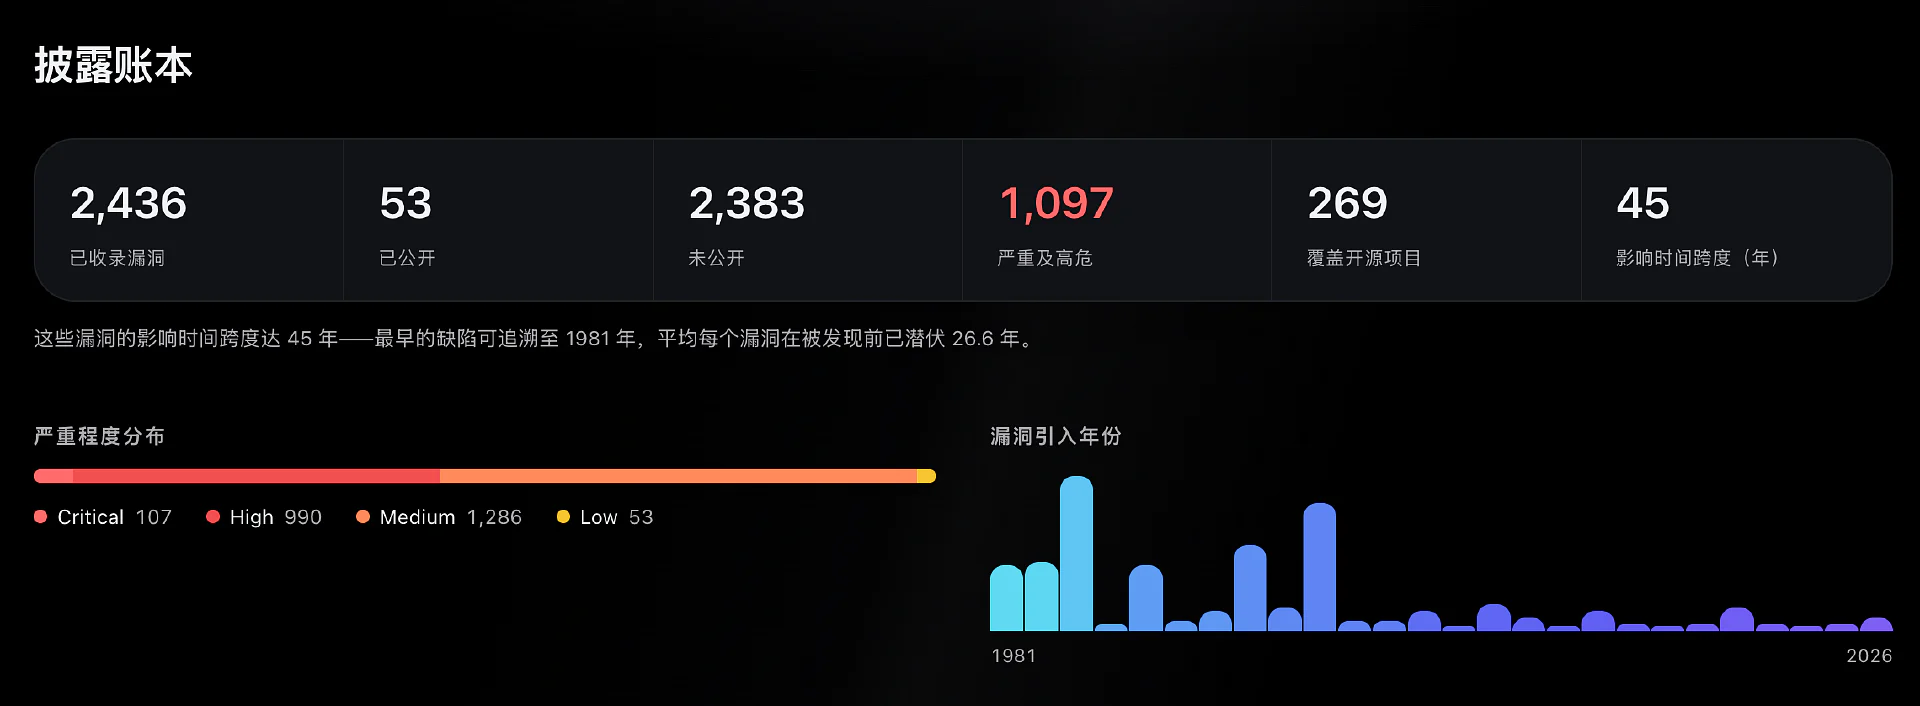
为持续跟踪这些漏洞的披露状态,智谱同时建立了 Security Disclosure Ledger,记录受影响项目、漏洞等级、CVE 编号以及漏洞存在时间等信息。
来源:Infoq