超微联合 IBM 和英伟达推出键值缓存方案,公布长上下文推理测试结果
StorageReview · 发布 2026/11/06 · 更新 2026/11/06
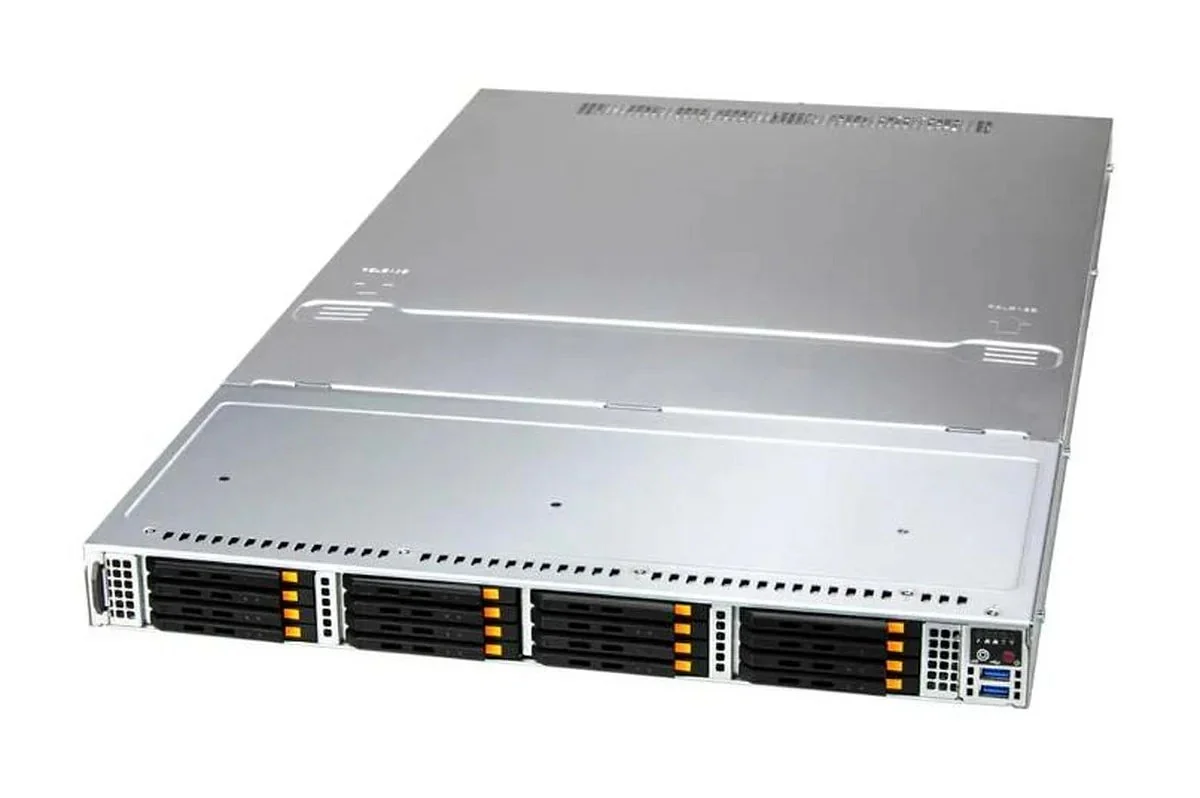
超微公布与 IBM、英伟达合作的键值缓存存储方案,将长上下文推理状态转移到共享全闪存层。厂商测试显示,十三万个输入词元场景的首词元等待时间显著缩短,但结果来自单张显卡,尚不能证明满规模集群表现。
超微今日宣布与 IBM、英伟达合作推出键值缓存存储方案,把长上下文推理所需的键值状态,从图形处理器移到共享全闪存层。方案结合采用 AMD EPYC 9005 处理器的超微 Petascale 存储服务器、IBM Storage Scale、英伟达 Dynamo 和 Spectrum-X 以太网,并由一套经过验证、以 IBM 红皮书形式发布的参考架构支持。厂商强调,在十三万个词元的提示下,与图形处理器从头重算上下文相比,首词元等待时间达到五十六倍改善。
键值缓存为什么需要存储层
推理分为两个阶段:预填充把提示转成词元并输入模型,生成中间键值状态;解码则基于这些状态,逐个词元生成回答。将键值状态保留在持久缓存中,可以在下一轮对话、下一步智能体操作,或共享同一上下文的下一次请求中复用,省去重新计算。
智能体工作流、编程助手、长上下文检索增强生成和多轮应用,会产生足以迅速耗尽图形处理器与中央处理器内存的状态数据,因此三家公司正在构建网络存储层。
在这一设计中,英伟达 Dynamo 管理缓存层级并通过 NIXL 传输数据块;IBM Storage Scale 纠删码版本提供共享文件层;Petascale 服务器提供闪存及其背后的第五代高速总线通道。超微称,三家公司在集群层面进行了高并发及带有其他业务干扰流量的测试,并将其作为包含工厂整柜集成、现场部署的一体化方案,声称可以将部署时间从数周缩短至数天。
测试配置
参考架构使用八台超微 ASG-1115S-NE316R Petascale 节点。每台是一高度单位、单路 AMD EPYC 9535 系统,配有十六块美光 7.68TB E3.S 固态盘,单节点原始闪存容量为 122.88TB,八台合计约 983TB。每个节点面向客户端配备双端口 200Gb 的英伟达 BlueField-3 B3220,存储后端配备 400Gb ConnectX-7;三台 Spectrum-X SN5600 交换机采用叶脊拓扑,上联带宽为每秒八百千兆比特。
存储节点运行 RHEL 9.6 与 IBM Storage Scale ECE 6.0.0.1,采用 8+2P 纠删码布局。IBM 根据早期测试,将这个八节点存储层的读取吞吐量定为每秒三百一十五吉字节。
| 组件 | 键值缓存参考架构(测试配置) |
|---|---|
| 存储层 | |
| 存储节点 | 8 台 Supermicro ASG-1115S-NE316R(1U,单路) |
| 每节点处理器 | AMD EPYC 9535,128 条 PCIe Gen5 通道(64 条用于 NVMe,64 条用于网络) |
| 每节点闪存 | 16 块 Micron 7.68TB E3.S NVMe(原始容量 122.88TB) |
| 每节点网络 | NVIDIA BlueField-3 B3220,双端口 200Gb(客户端侧) NVIDIA ConnectX-7 400Gb(存储后端) |
| 交换网络 | 3 台 NVIDIA Spectrum-X SN5600,叶脊拓扑,800Gb/s 上联 |
| 存储软件 | IBM Storage Scale Erasure Code Edition 6.0.0.1,8+2P RHEL 9.6 |
| 推理客户端 | |
| 系统 | Supermicro SYS-212GB-FNR(NVIDIA MGX),Ubuntu 24.04 |
| 基准测试使用的图形处理器 | 1 张 NVIDIA RTX PRO 6000 Blackwell,加载权重及 CUDA 图后,剩余 19.6GiB 用于键值缓存 |
| 客户端网络 | 2 张 NVIDIA BlueField-3 B3140H 400Gb/s,面向客户端的带宽最高 80GB/s |
| 模型与软件 | openai/gpt-oss-120b(MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0,配合 NIXL NVIDIA AIPerf 基准测试客户端 |
| 缓存分层 | 主机及本地层设为零;全部 1.4 百万个缓存词元均由 Storage Scale 层提供 |
基准测试客户端是一台超微 SYS-212GB-FNR MGX 系统。所有结果均来自其中一张英伟达 RTX PRO 6000 Blackwell 显卡,在 vLLM 0.14.1 和 Dynamo 0.9.0 下,以 MXFP4 格式运行 openai/gpt-oss-120b 模型。
加载权重和计算图后,显存剩余 19.6GiB 可用于键值缓存,足够在显卡本身容纳约一百一十四万个词元。测试时,主机内存和本地层被设为零,每一个缓存块都从共享存储层返回,因此结果单独衡量存储路径,不包含混合层级的帮助。
首词元时间改善五十六倍,吞吐量提高二十二倍
没有缓存时,这个一千二百亿参数模型的首词元等待时间,会随着输入从一万个词元增加到十三万个词元,由 0.572 秒上升至 32.14 秒,因为显卡需要重新计算完整上下文。使用共享存储层中的键值缓存后,同一区间的等待时间保持在 0.193 至 0.57 秒之间。这对应十三万个词元处的五十六倍改善,以及超微公告提到的 0.377 秒波动范围。测试由三家厂商完成,StorageReview 并未亲自运行或审计这些结果。
吞吐测试通过二十八个并发连接发送二百个请求,来自一百条不同提示,总计两千四百万个词元和 825GB 键值缓存数据,缓存初始为空。重新计算的基线以每秒 0.19 个请求、耗时一千零四十八秒完成;共享存储层则以每秒 4.26 个请求、耗时 46.94 秒完成,提升二十二倍,其中已经计入冷启动填充缓存的成本。
第三轮测试增加四个客户端,在同一网络上传送每秒二百吉字节的无关流量。使用缓存的配置仍保持每秒 3.6 个请求,在 55.56 秒内完成二百个请求,比无干扰时慢约九秒,但仍达到基线的十八倍。IBM 将较小的性能损失归因于交换网络把缓存流量与背景负载隔离。
英伟达推理产品负责人什鲁蒂·科帕卡尔表示:“智能体人工智能和长上下文应用,需要在多个步骤中高效复用上下文。英伟达 Dynamo 帮助编排分布式推理,使企业可以从每块图形处理器获得更多可用吞吐量。将英伟达 Dynamo 和 Spectrum-X 以太网,与超微 Petascale 存储服务器及 IBM Storage Scale 结合,这个键值缓存方案建立起高性能共享存储层,可以减少重复计算、改善首词元时间,并帮助客户扩展具有韧性的人工智能推理服务。”
规模规划与数字没有体现的部分
IBM 的容量规划指南将四节点配置设为 4+2P、可用容量百分之六十七,面向七十亿至三百四十亿参数模型、最多六十四块图形处理器;测试中的八节点配置为 8+2P、可用容量百分之八十,面向七百亿至一千二百亿参数模型、一百至二百五十六块图形处理器,所需读取带宽为每秒一百至三百吉字节。十六个或更多节点采用 16+3P、可用容量百分之八十四,面向更大模型、三百块及以上图形处理器,带宽从每秒三百吉字节起。纠删码存储系统本身可从三台存储服务器扩展到二百五十六台。
单张显卡的测试配置是最主要的限制。参考架构面向数百块图形处理器,但文中的每项结果,都是一张显卡访问八节点、983TB 闪存层得到的,而 IBM 标称这个存储层能够提供每秒三百一十五吉字节吞吐量。因此,存储端远未饱和,测试并没有展示整个图形处理器集群同时读取缓存时,首词元等待时间能保持在什么水平。
超微尚未公布整套方案的售价或上市时间,公告也未提供图形处理器利用率数据。这一路线与 DDN 在 AI400X3M 上集成 Dynamo 的键值缓存加速方案处于相同领域,区别是这里采用通用超微服务器和以太网,并运行在 IBM 文件系统之下。
超微总裁兼首席执行官梁见后表示:“随着人工智能工作负载从训练扩展到推理,部署智能体及长上下文、多轮生成式人工智能所需高吞吐推理工作负载的企业和新型云服务商,需要消除瓶颈、提高图形处理器效率。我们与 IBM、英伟达合作的方案清楚展示了这些性能收益。”