人工智能基础设施的下一次演变:推动人工智能工厂时代的架构内部
编辑部 · 发布 2026/07/24 · 更新 2026/07/28
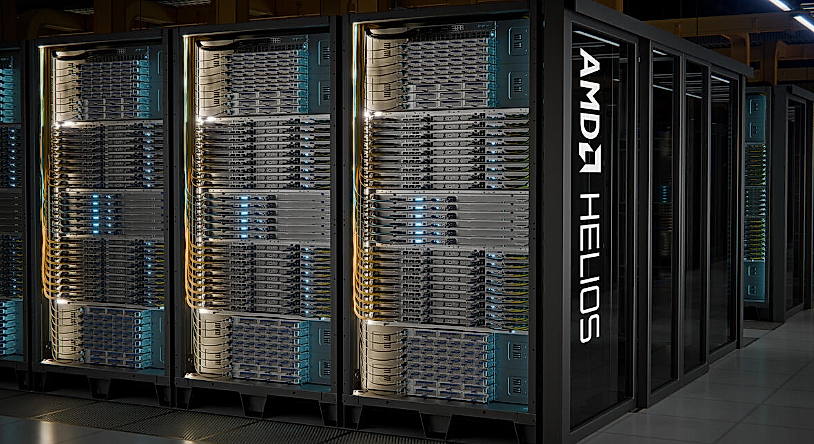
人工智能工厂不再是未来;它们正在成为超大规模人工智能的新蓝图。随着企业和云提供商从部署单独的人工智能服务器转向构建能够支持大量推理和训练工作负载的人工智能工厂,基础设施必须从独立系统发展到集成的机架规模设计。
人工智能工厂不再是未来;它们正在成为超大规模人工智能的新蓝图。 随着企业和云提供商从部署单独的人工智能服务器转向构建能够支持大量推理和训练工作负载的人工智能工厂,基础设施必须从独立系统发展到集成的机架规模设计。
这一转变成为 Lenovo Tech World '26 的中心舞台,AMD 董事长兼首席执行官苏姿丰 (Lisa Su) 博士在会上宣布联想是最早采用 AMD Helios™ 机架级解决方案的 OEM 厂商之一。 联想正在应用数十年的基础设施工程专业知识来帮助客户构建下一代人工智能工厂——从纵向扩展和横向扩展集群设计到保持人工智能环境大规模运行的部署和生命周期服务。
AMD Helios™ 专为下一个生成式和代理式 AI 时代而设计,将下一代 AMD Instinct™ GPU、AMD EPYC™ CPU、AMD Pensando™ 网络技术和 AMD ROCm™ 软件生态系统整合到一个基于开放计算项目 (OCP) 和开放机架宽 (ORW) 规范构建的开放机架级架构中。 离子。 该解决方案专为超大规模推理、训练和微调而设计,可从机架级系统扩展到数据中心规模集群,以进行分布式推理和最大的基础模型训练运行。
为了支持这种规模的人工智能,该平台在单个机架中结合了 72 个 AMD Instinct™ MI455X GPU、下一代 AMD EPYC™ 处理器、31TB HBM4 内存和 AMD Pensando™ 网络技术。 结果是 FP4 AI 推理性能高达 2.9 exaFLOPS,FP8 AI 训练性能高达 1.4 exaFLOPS,为超大规模企业和 NeoCloud 提供商提供了训练、微调和服务日益复杂的 AI 模型所需的性能。
联想副总裁兼云服务提供商总经理 Conor Malone 表示:“人工智能基础设施正在从独立服务器快速发展为完全集成的机架级集群。” “我们与 AMD 合作,将世界一流的集群设计与联想在大规模部署方面的专业知识结合在一起,帮助客户利用该解决方案构建开放、可扩展且为未来做好准备的 AI 环境。”
不仅仅是硬件:更快的部署路径
让组织为人工智能新时代做好准备不仅仅是部署新硬件。它需要集群设计、液体冷却、工作负载优化和生命周期管理方面的专业知识。 凭借其在部署大规模人工智能基础设施方面的成熟经验,联想帮助客户加速部署、优化性能、缩短首次令牌的时间,并更快地将人工智能环境投入生产。
联想的工程和服务专家与客户一起评估工作负载需求、调整部署规模、优化 GPU 配置并针对当前工作负载调整性能。 从此,持续的全生命周期服务功能可减少启动时间,并以更高的速度和效率支持长期差异化,帮助组织最大限度地提高 GPU 利用率并降低部署风险。
人工智能工厂可能正在改变基础设施的构建方式,但联想的目标保持不变:帮助组织将人工智能部署到能带来最大价值的地方。 通过混合人工智能愿景,联想正在构建开放、可扩展的基础设施,使客户能够在边缘、企业、云和超大规模环境中运行人工智能,满足他们当前的需求,同时帮助他们为未来做好准备。 基于 AMD Helios 机架级解决方案的联想解决方案预计将于 2026 年第四季度上市。
来源:News