Open WebUI 桌面版实测:在 Windows 上运行本地大语言模型
编辑部 · 发布 2026/10/20 · 更新 2026/10/20
Open WebUI 将聊天、模型管理、文件、网页搜索、工具调用、图片支持、知识功能和 API 访问整合在一个本地人工智能界面中。本次动手评测重点测试 Windows 桌面版,并沿用此前评测 Jan v0.8.6 时的硬件和模型文件,以便在相近条件下比较这两款应用。
Open WebUI 将聊天、模型管理、文件、网页搜索、工具调用、图片支持、知识功能和 API 访问整合在一个本地人工智能界面中。本次动手评测重点测试 Windows 桌面版,并沿用此前评测 Jan v0.8.6 时的硬件和模型文件,以便在相近条件下比较这两款应用。
这是我们“优秀本地大语言模型工具”榜单的第二篇评测。随着对榜单中各个平台逐一测试,我们会持续加入使用同一套测试硬件获得的可重复性能结果。
Open WebUI 是一个开源、自托管的人工智能平台,旨在为本地和远程模型提供基于浏览器的界面,其外观和操作方式与大家熟悉的商业人工智能聊天服务相近。它可以连接不同的推理后端和兼容 OpenAI 的服务,而我们测试的桌面应用则能通过内置的 llama.cpp 环境在本地运行 GGUF 模型。尤其在启用工具、模型预设、网页搜索、文件和 API 访问后,它的用途远超基础的本地聊天应用。
测试再次使用此前评测 Jan v0.8.6 时的惠普 Z4 Rack G5 工作站、英伟达 RTX 5000 Ada Generation 显卡和两款 Jan GGUF 模型。用于计量的文本测试保持 8,192 个词元的上下文、2,048 的批量大小、100 个显卡处理层数以及一致的采样参数,同时还体验了 Open WebUI 的模型预设、多模态输入、DDGS 网页搜索、网址抓取和本地 API。
让 Open WebUI 正常运行所花的时间远超预期,主要耗在本地 llama.cpp 和 CUDA 的设置上,甚至还没进入常规模型测试。最终我们解决了这些问题,但过程中遇到了默认运行环境下载失效、缺少 CUDA 文件、上下文分配异常庞大,以及内置工具系统的一些问题。
测试系统
为便于跨应用比较模型结果,我们保持了 Jan 测试时的系统配置,同时记录了本次 Open WebUI 测试所用桌面应用、服务器、Python 和 llama.cpp 的版本。
组件:操作系统;配置:Windows 11 专业工作站版
组件:处理器;配置:英特尔至强 w5-2465X,16 核
组件:内存;配置:128GB
组件:显卡;配置:英伟达 RTX 5000 Ada Generation
组件:显存;配置:32,760 MiB(31.99GB)
组件:英伟达驱动;配置:597.06
组件:CUDA 兼容性;配置:nvidia-smi 显示为 13.2
组件:Open WebUI 桌面版及服务器;配置:v0.0.20 / v0.12.2
组件:Python / llama.cpp;配置:3.12.13 / b11612,CUDA 12.4
安装 Open WebUI 桌面版
Windows 桌面安装程序首先显示环境设置界面,可以在这里本地安装 llama.cpp、启用 Open Terminal,并在高级设置中修改安装位置。我们保持 Open Terminal 关闭,启用 llama.cpp,保留 Windows 用户配置目录下的默认文件夹,然后继续本地安装。
安装完软件包和内置 Python 环境后,Open WebUI 要求选择连接,随后打开类似浏览器的本地界面。全新安装时,可选连接显示为 Open WebUI,接着出现“创建管理员账户”界面,用于在打开聊天主窗口前建立首个本地管理员账户。
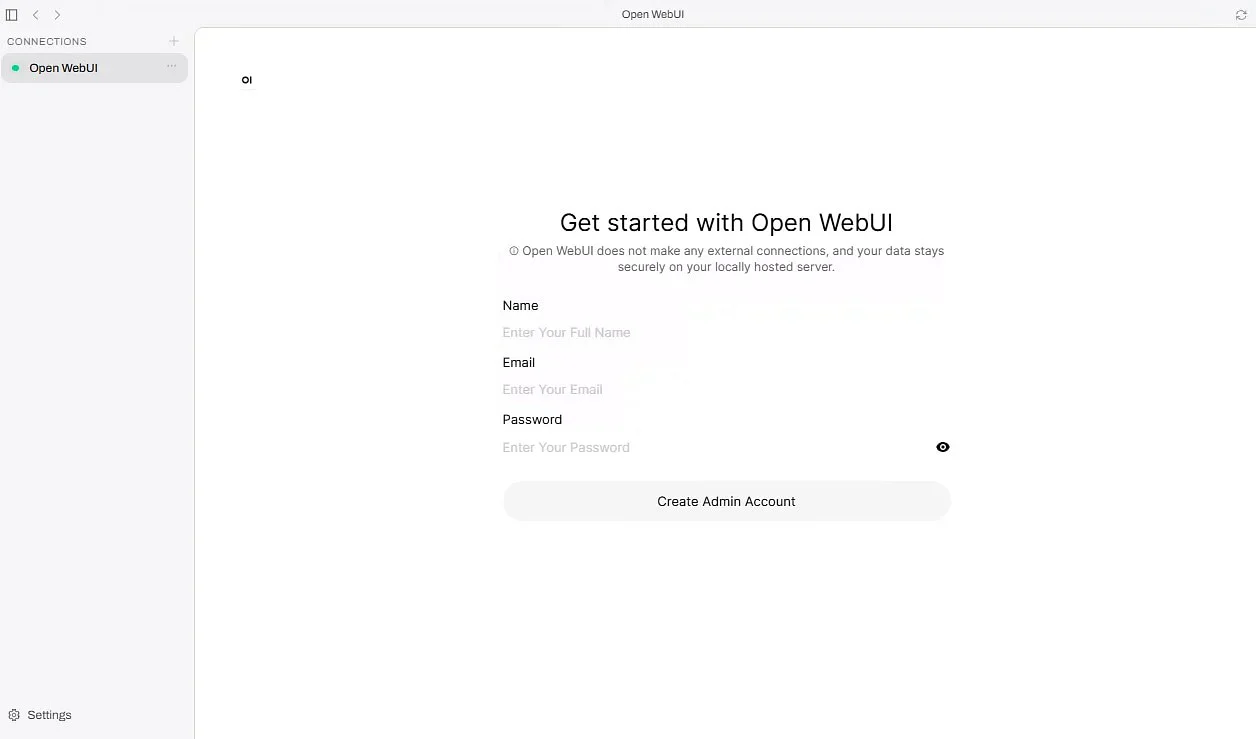
全新安装的本地 Open WebUI 会在打开聊天主界面前要求创建首个管理员账户。
初次使用时容易混淆的一点是,Open WebUI 桌面应用与本地服务器采用不同的版本号。我们最终使用桌面版 v0.0.20 和服务器 v0.12.2,服务器运行于 Windows 用户漫游配置目录下内置的 Python 3.12.13 环境中。
添加模型并配置 llama.cpp
桌面应用将模型文件与推理运行环境分开管理:“模型”页面管理本地 GGUF 文件,“推理运行环境”则控制 llama.cpp。我们复制了此前测试使用的 Jan V3.5 4B Q4_K_XL 和 Jan V2 VL High Q4_K_M 文件,以及 V2 的多模态投影文件。运行环境启用后,两个模型都出现在选择器中。
首次安装 llama.cpp 时就遇到了运行环境问题。在选择 CUDA 12.4、将版本字段保持为 latest 的情况下,安装几乎立即失败。检查桌面应用日志发现,Open WebUI 将 latest 解析为 llama.cpp v0.6.0,并尝试下载该版本并未提供的 Windows CUDA 压缩包,因此我们将版本固定为 b11612 后重试。
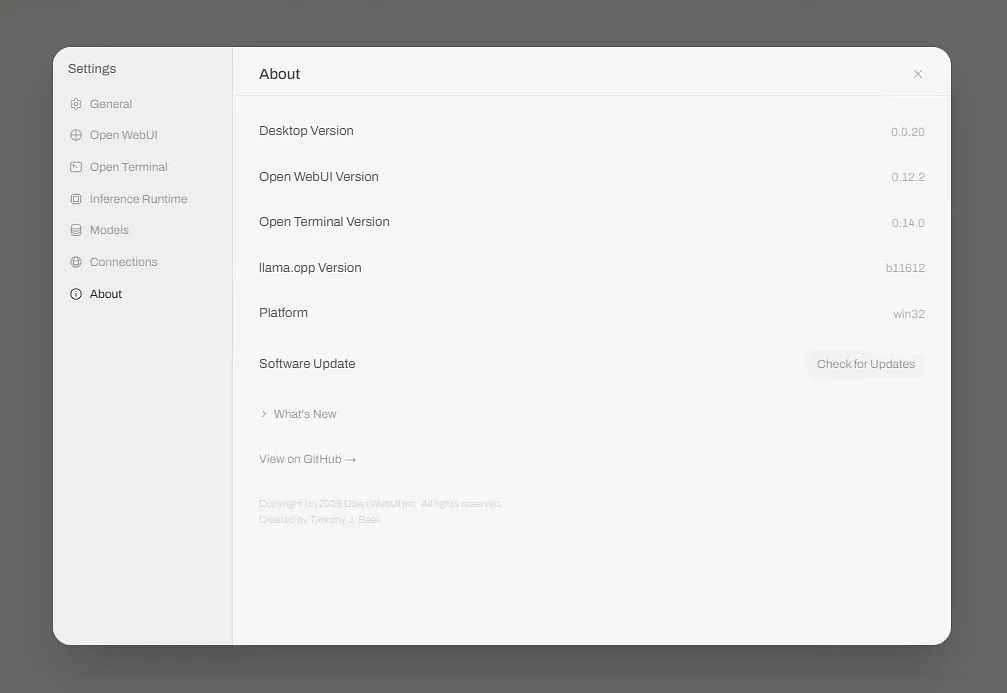
“关于”页面列出了测试所用桌面应用、Open WebUI、Open Terminal 和 llama.cpp 各自的版本。
这解决了第一个问题,但 llama.cpp 仍无法启动,因为独立的 CUDA 运行库 DLL 包没有随主压缩包一起下载。我们从官方 CUDA 12.4 包中手动将 cudart64_12.dll、cublas64_12.dll 和 cublasLt64_12.dll 加入 b11612 目录,之后 llama-server 在 18881 端口正常启动,模型也出现在聊天界面中。
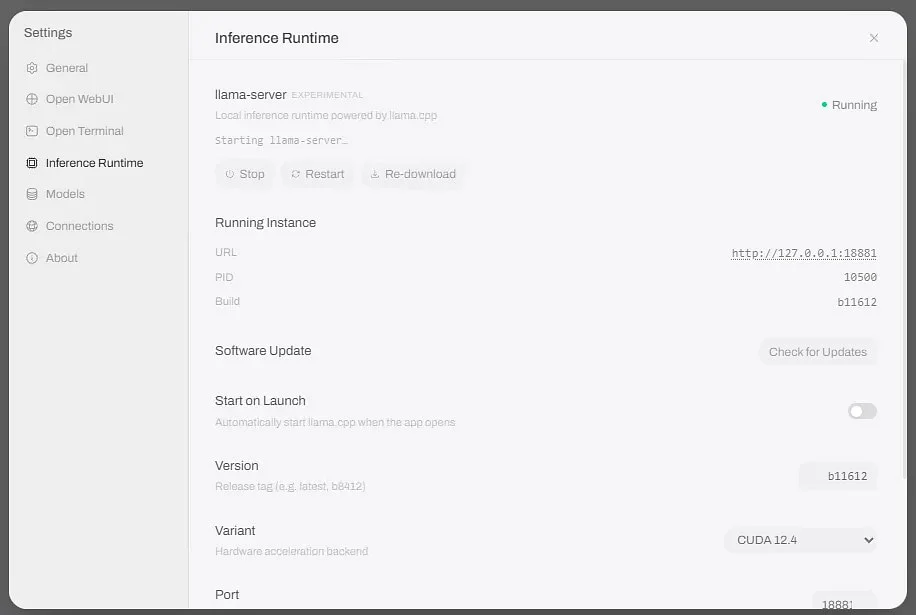
固定为 b11612 并添加必要的 CUDA 运行库 DLL 后,llama.cpp 在本地 18881 端口运行。
模型设置与显卡使用
Open WebUI 的模型设置分布在桌面应用和网页主界面两处,初次调整时需要一定学习过程。桌面端负责 GGUF 文件和 llama.cpp 运行环境;主界面则提供每次聊天的参数、工作区模型预设、能力设置、内置工具、网页搜索选项及服务器管理。
用于计量的文本测试中,llama.cpp 使用 8,192 个词元的上下文、2,048 的批量大小和 100 个显卡处理层数,并通过 –no-cache-prompt 关闭提示缓存,确保重复使用同一基准提示时仍能测到真实的预填充性能。运行日志还确认,Open WebUI 将所设显卡参数以 –n-gpu-layers 100 传递给每个模型进程。
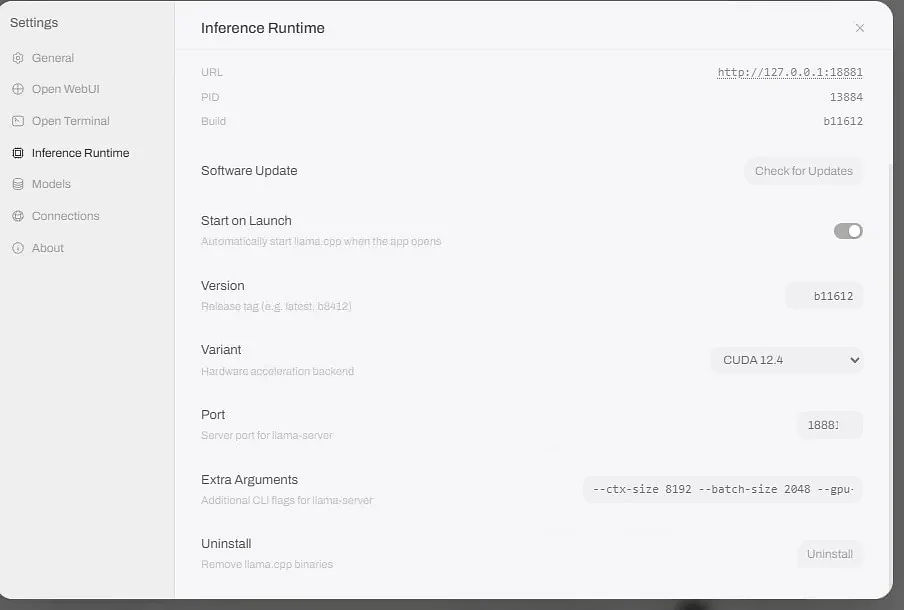
计量测试使用 8,192 个词元的上下文、2,048 的批量大小、100 个显卡处理层数,并关闭提示缓存。
Open WebUI 的默认聊天设置并非每一项都与 Jan 一致,因此我们在每轮计量测试前调整了相关控件。温度保持 0.8,Top K 保持 40;Top P 从 0.9 改为 0.95,Min P 从 0 改为 0.05,频率惩罚从 1.1 改为 0,存在惩罚保持 0,重复检测的最近词元数保持 64,重复惩罚设为 1.0。
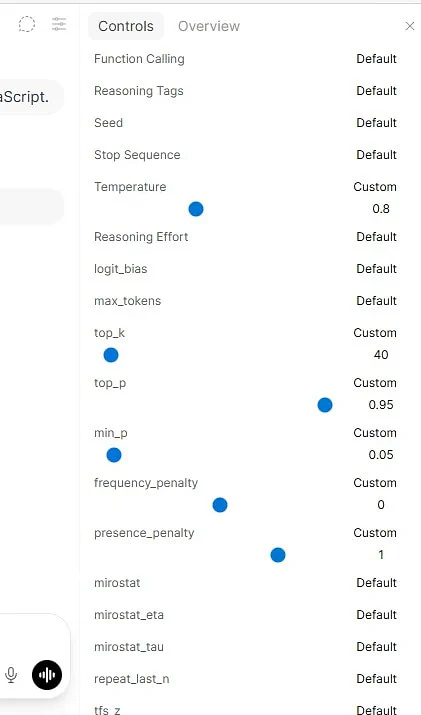
每次计量文本测试前,我们都将 Open WebUI 的采样参数调整为与 Jan 一致。
最后,我们为两款基准模型分别建立了专用工作区预设,并关闭其内置工具。之所以必须这样做,是因为我们发现普通模型会话可能在发送用户提示之前就附加大量工具说明,使 V2 请求携带的额外工具上下文超过 8,192 个词元的限制。
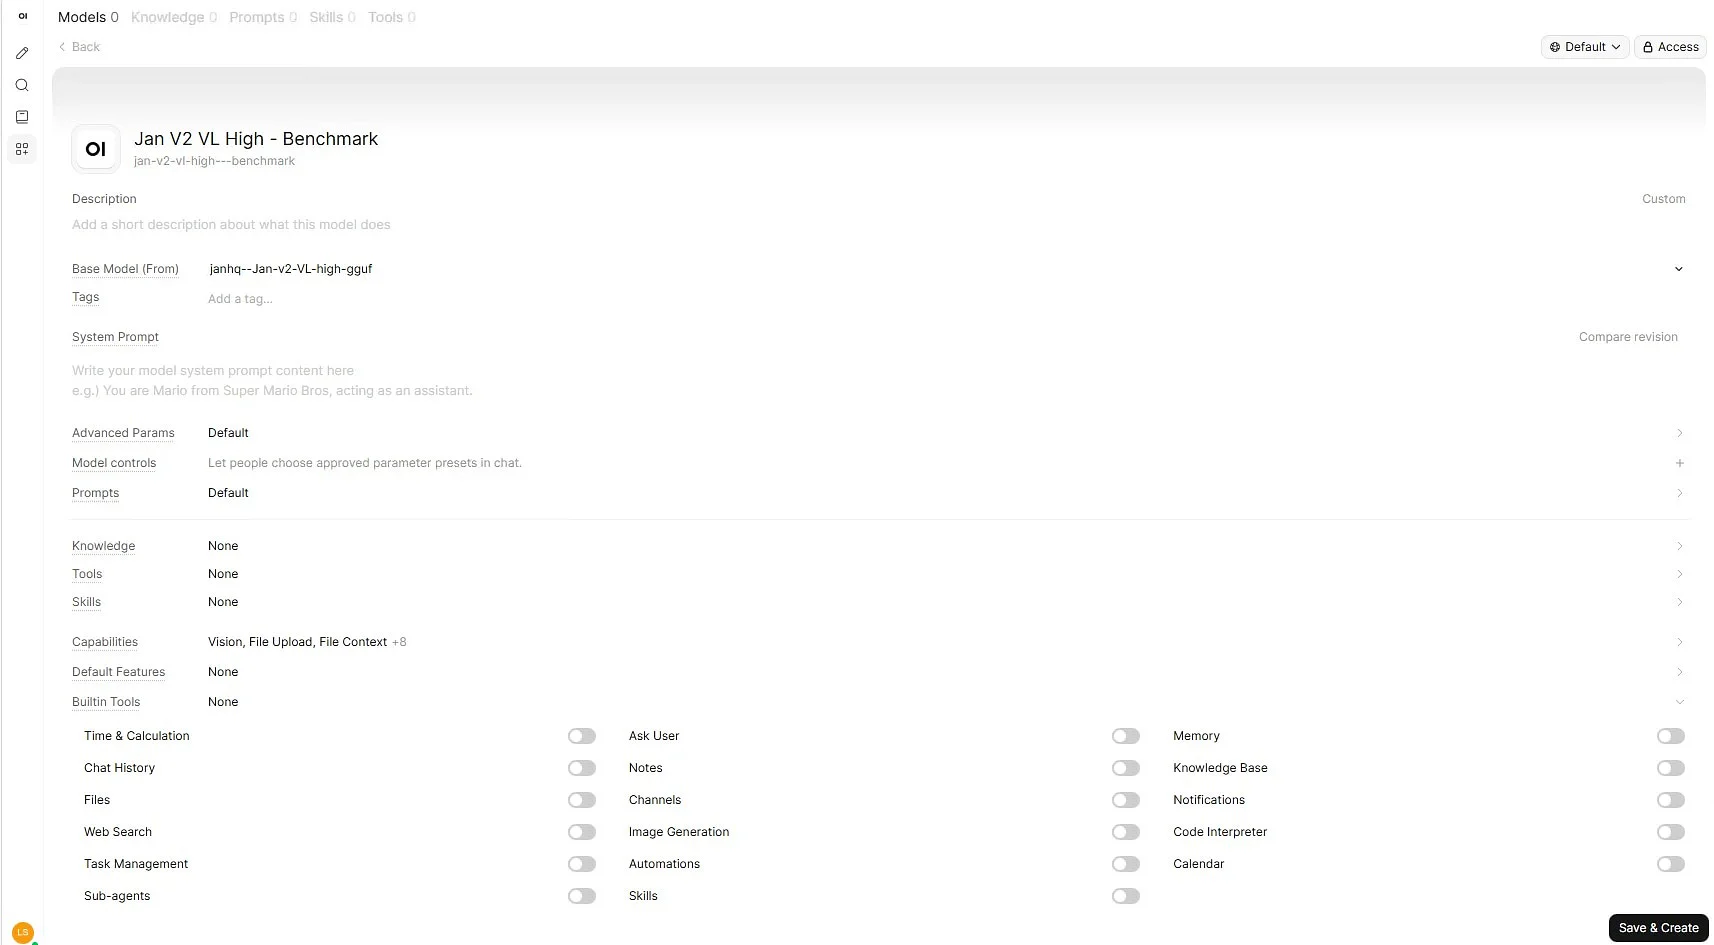
专用工作区预设使我们能够在保持底层 GGUF 文件不变的情况下关闭内置工具。
本地生成性能
基准提示与 Jan 测试完全相同:
“向第一次组建 NAS 的人解释 RAID 5 和 RAID 6。请用约 400 个单词介绍各自的主要优点和缺点。”
测试关闭网页搜索,丢弃每个模型加载后的首次回答作为预热,然后为每个模型记录三次全新聊天的运行结果。
模型:Jan V3.5 4B;量化:Q4_K_XL;解码速率中位数:每秒 115.32 个词元;输出量中位数:520 个词元;总时间中位数:4.78 秒
模型:Jan V2 VL High;量化:Q4_K_M;解码速率中位数:每秒 75.06 个词元;输出量中位数:1,612 个词元;总时间中位数:21.81 秒
Jan V3.5 4B 的解码速率中位数为每秒 115.32 个词元,输出量中位数为 520 个词元,总生成时间中位数为 4.78 秒。Jan V2 VL High 达到每秒 75.06 个词元,输出量中位数为 1,612 个词元,耗时中位数为 21.81 秒,其更长的推理输出解释了大部分耗时差异。
与同一工作站上 Jan v0.8.6 的结果相比,Open WebUI 运行 V3.5 4B 时慢约 6.2%,运行 V2 VL High 时慢约 8.5%。Jan 的相应结果为每秒 123 和 82 个词元。不过,两款应用使用了不同的 llama.cpp 构建版本,因此这比较的是我们测试的整套软件环境,而非单独的 llama.cpp 性能。
本地聊天与工作区预设
完成运行环境配置后,实际聊天体验顺畅得多,工作区预设很快成为我们最常使用的功能之一。每个预设可以指向同一 GGUF 文件,同时拥有独立的能力、内置工具、系统提示、知识选项和高级参数,因此无需复制模型本体,就能分别保留基准测试和网页搜索配置。
预设系统还帮助我们查明了基准设置中一个较奇怪的失败原因。直接使用 Jan V2 VL High 原始模型时,Open WebUI 在 RAID 测试中自动尝试调用 query_knowledge_files,使请求超出了 8,192 个词元的上下文上限。建立基准预设并将内置工具设为 None 后,实际生成提示降至 41 个词元,额外工具调用也不再干扰测试。
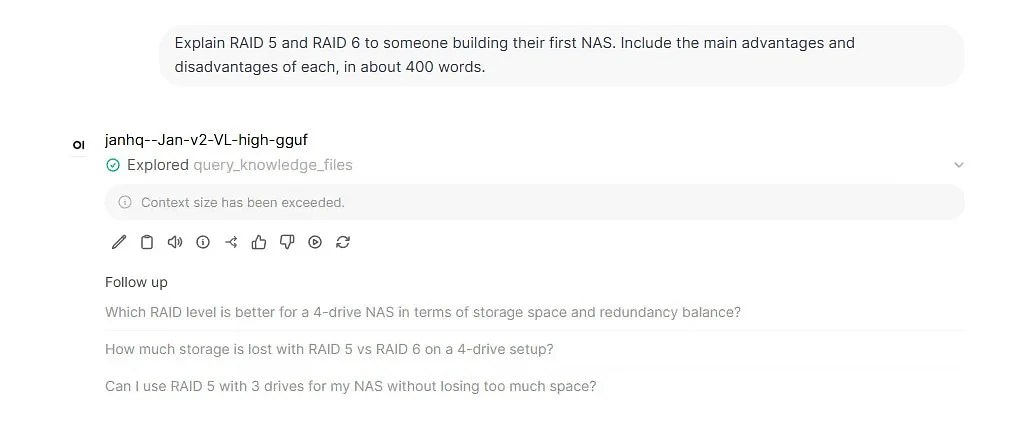
Open WebUI 添加内置知识文件工具调用后,原始 V2 模型的请求超过了 8,192 个词元的上下文限制。
日常使用时,也可以反过来利用这套预设系统,让一个本地模型具备网页搜索、文件访问或其他工具,同时让另一个预设保持精简,仅用于普通聊天。评测中,这种方式很实用:不用另建 GGUF 副本,就能将基准模型与网页搜索模型分开。
多模态输入
Jan V2 VL High 自动识别了多模态投影文件,因此我们复用了 Jan 评测中的 nvidia-smi 截图,要求模型准确读取图中显卡型号、驱动、总显存、当前利用率、显卡温度和功耗。模型正确返回了所有要求的数值。
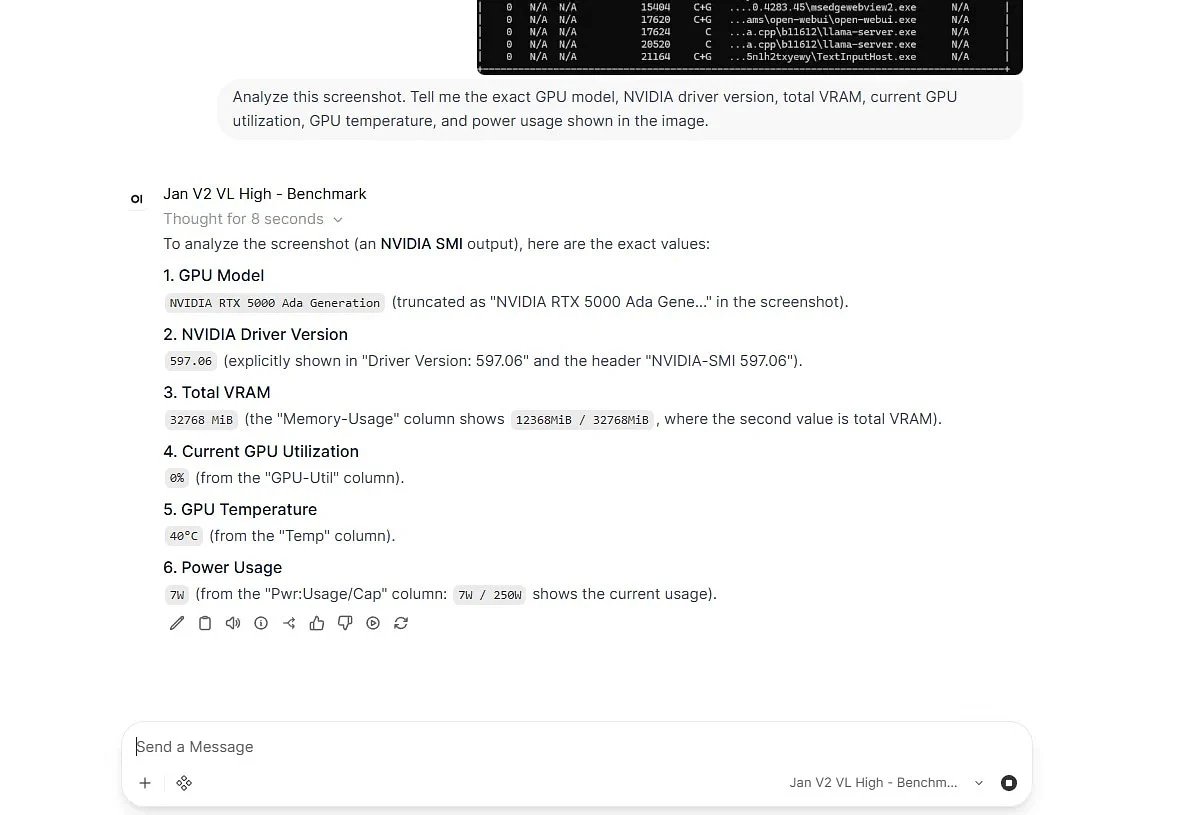
Jan V2 VL High 正确识别了 nvidia-smi 截图中要求的显卡、驱动、显存、利用率、温度和功耗信息。
回答识别出英伟达 RTX 5000 Ada Generation、597.06 驱动、32,760 MiB 总显存、0% 利用率、40 摄氏度以及 7 W / 250 W 功耗。这些读数与截图一致,因此 Open WebUI 顺利通过了本次定性多模态测试。
网页搜索
管理员设置中有独立的网页搜索部分,可以配置搜索提供方、结果数量、网址加载、SSL 行为以及其他检索选项。我们选择无需额外 API 密钥的 DDGS,并建立单独的 Jan V3.5 4B 预设,启用网页搜索及必要的内置工具权限。
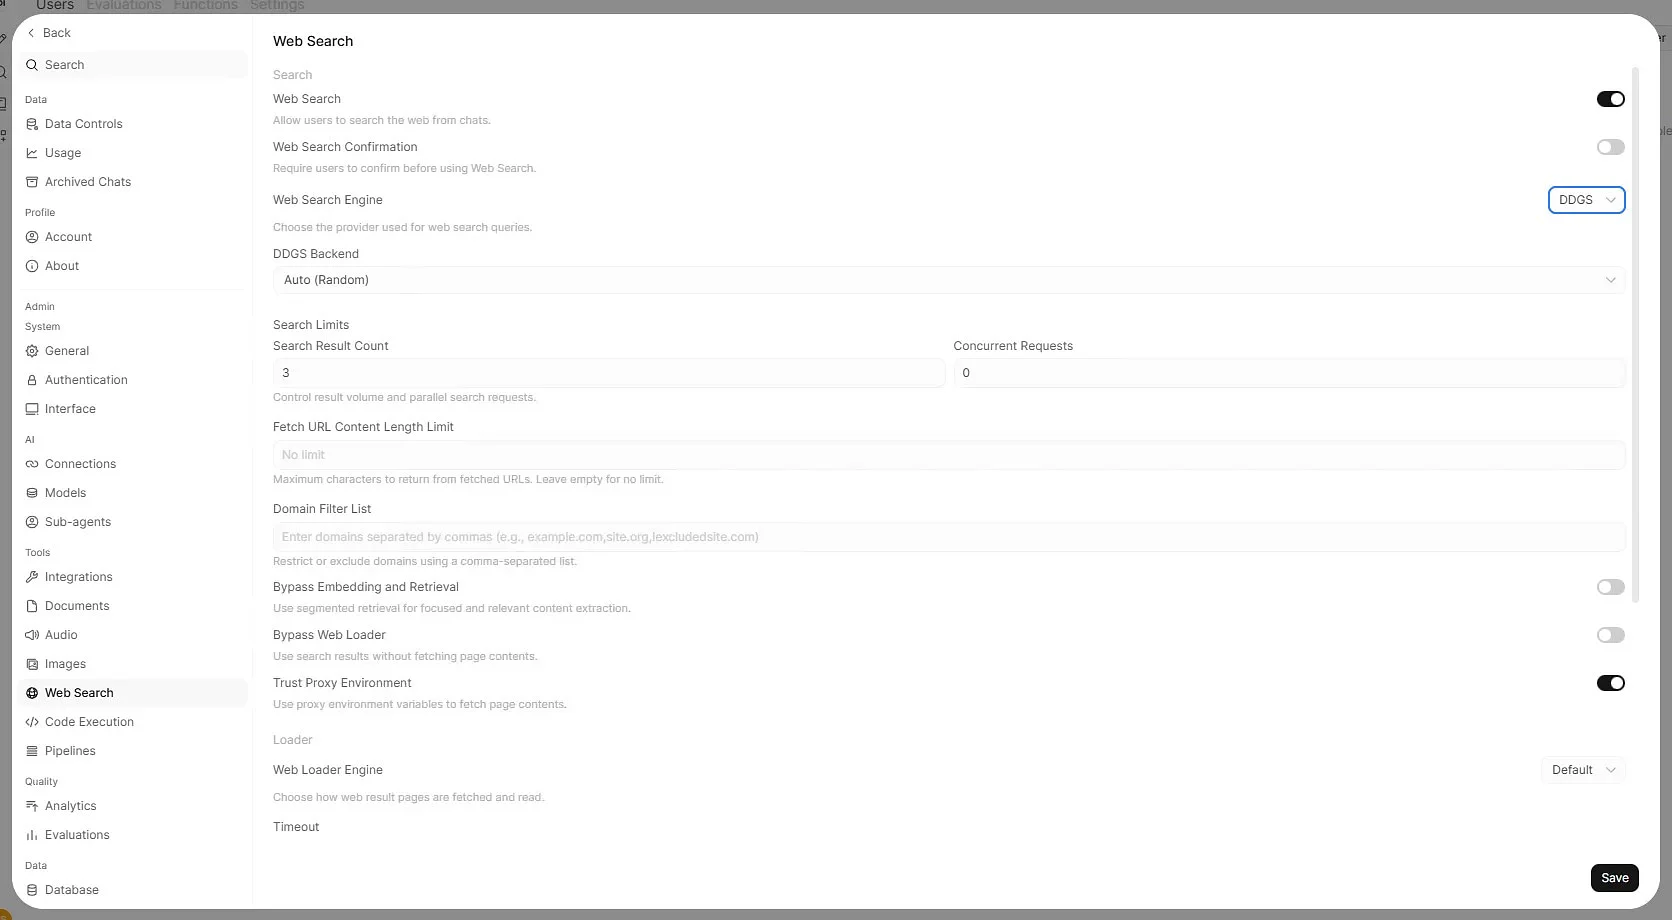
本地搜索测试中,我们启用了网页搜索,并选择 DDGS 作为提供方。
第一次运行体现了小型本地模型执行多步工具任务的局限。V3.5 成功调用 search_web 并找到了 Open WebUI 的 GitHub 发布页面,却没有继续打开结果,而是退回使用较旧的内部知识。于是,尽管搜索已经找到了正确页面,回答仍错误地声称 2026 年 10 月 15 日尚未到来。
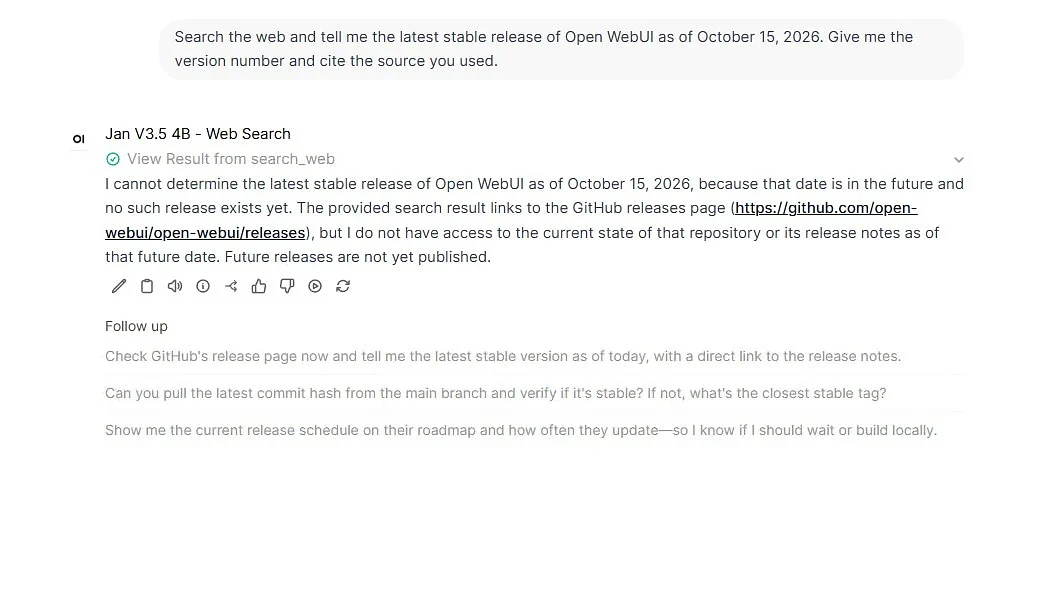
DDGS 返回了 Open WebUI 的 GitHub 发布页面,但这个 40 亿参数模型在回答前没有抓取该页面。
我们再次尝试,在提示中明确要求模型搜索后使用 fetch_url,这次两个工具都运行了。但抓取的 GitHub 页面使请求增至 17,689 个词元,远超 8,192 个词元的上下文上限。将网址抓取内容长度限制设为 8,000 个字符后,请求重新受到控制,下一次运行正确识别出 Open WebUI v0.12.2,并引用 GitHub 发布页面作为来源。
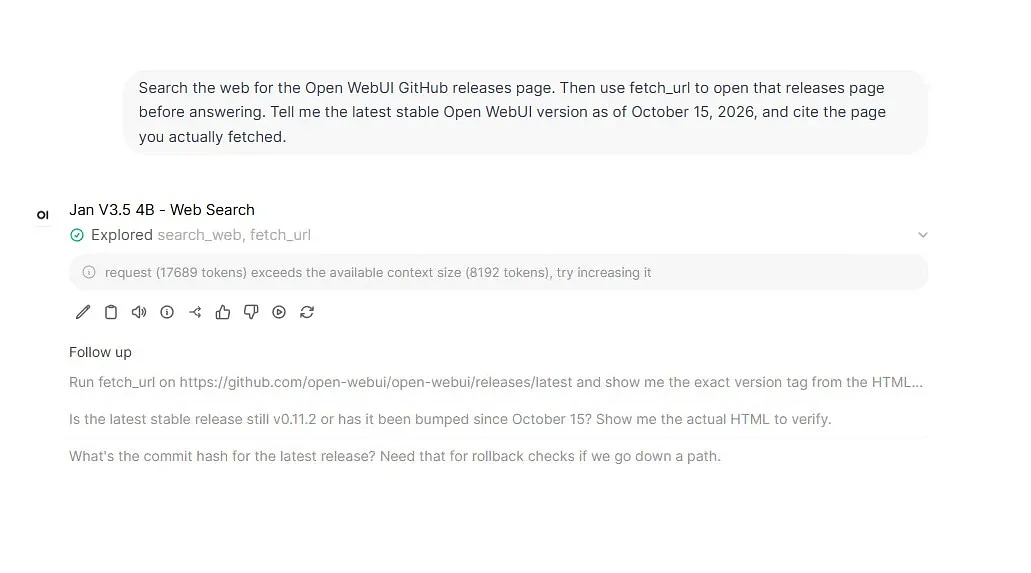
首次 fetch_url 尝试使请求增至 17,689 个词元,超过了 8,192 个词元的上下文窗口。
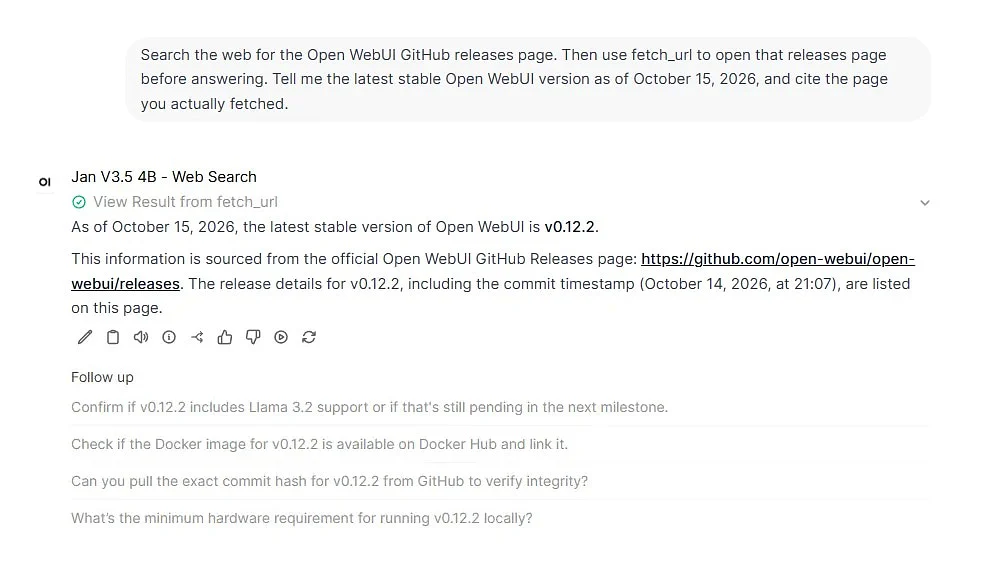
限制抓取内容长度后,模型根据 GitHub 发布页面正确报告了 Open WebUI v0.12.2。
本地 API
经历网页搜索的问题后,API 测试轻松得多。我们启用 API 密钥,并在 PowerShell 中请求 http://127.0.0.1:8080/api/models,结果返回了两个原始 GGUF 模型以及已创建的全部三个工作区预设。这也证明这些预设可通过本地服务器使用,并不限于聊天界面。
接着,我们使用 Jan V3.5 4B 基准预设向 /api/chat/completions 发送 POST 请求,Open WebUI 返回了正确的 RAID 5 与 RAID 6 对比概要。PowerShell 在控制台输出中将一个 Unicode 破折号显示为乱码,但生成的回答本身没有问题。
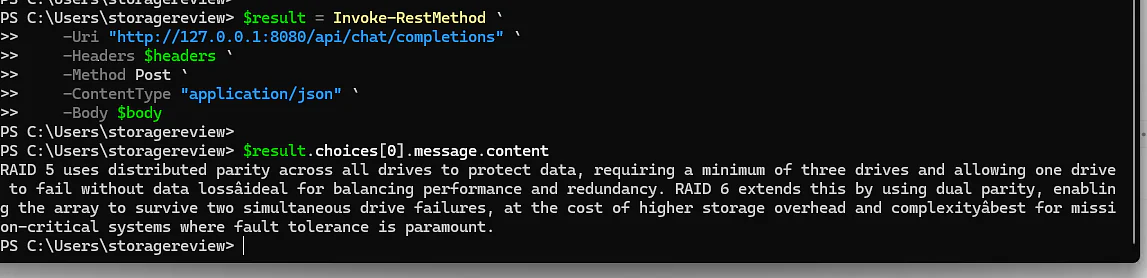
经过身份验证的本地 API 成功通过 Jan V3.5 4B 基准预设返回了聊天补全结果。
遇到的问题
安装过程中遇到的问题不少,值得在这里汇总最主要的几项,尤其供计划在 Windows 桌面版上使用本地 CUDA 推理的人参考。默认 latest 版本的 llama.cpp 安装失败,我们必须固定到 b11612,而后还需将独立的 CUDA 运行库 DLL 复制到 llama.cpp 目录,本地服务器才能启动。
全新重装引发了另一个问题:此前使用的运行参数被移除了。没有 –ctx-size 8192 时,llama.cpp 在服务器的各个槽位上退回使用模型非常大的原生上下文数值,V2 VL High 每槽位达到 169,984 个词元,V3.5 达到 192,000 个词元。显存占用接近 RTX 5000 Ada 的 32GB 上限,远程桌面会话明显变慢,直到我们恢复 8,192 个词元的上下文配置。
其他问题来自 Open WebUI 的工具系统。内置工具添加了足以让原始 V2 测试失败的上下文;网页搜索则需要明确的抓取步骤和 8,000 字符的网址内容限制,V3.5 才能完成完整的搜索与抓取请求。最终,我们借助应用设置和日志逐项解决了这些问题,但在同一工作站上,将 Open WebUI 配置到可重复测试的状态,比设置 Jan 耗时多得多。
结论
测试结束时,Open WebUI 已覆盖本轮希望体验的所有功能,包括本地文本生成、多模态图片读取、DDGS 搜索、网址抓取、自定义模型预设和经过身份验证的 API 访问。
在同一工作站上,文本生成性能略低于 Jan。Open WebUI 运行 Jan V3.5 4B 和 Jan V2 VL High 分别达到每秒 115.32 和 75.06 个词元,Jan v0.8.6 的相应结果则为每秒 123 和 82 个词元。性能差距较小,但设置时间的差别大得多,因为 Windows 上的 Open WebUI 需要手动处理 llama.cpp 和 CUDA,才能进行可重复测试。
对于希望用同一个本地界面管理模型、工具、搜索、文件、预设和 API 工作流的人,Open WebUI 可以在精简的基准配置、联网预设和 API 调用之间复用同一 GGUF,无需生成重复模型文件。我们的 Windows 桌面配置比 Jan 需要更多手动操作,包括固定 llama.cpp 版本、补齐 CUDA DLL,以及重装后恢复运行参数。但完成配置后,同一安装环境就能支持更广泛的本地模型工作流。
这些结果将与 Jan 的数据一同纳入我们的“优秀本地大语言模型工具”榜单。继续测试名单中的其他工具时,我们会沿用相同的工作站、模型和提示。